Software Benchmarking
Abstrakt: Im Jahr 2020 wurden auf GitHub über 60 Millionen neue Repositories von mehr als 56 Millionen Usern angelegt (Quelle: GitHub). Bei kleineren Projekten mit wenigen Entwicklerinnen und Entwicklern besteht in der Regel ein gemeinsames Verständnis der Codebasis. Der Zustand eines Repos lässt sich vergleichsweise leicht beurteilen. Mit zunehmender Größe und Komplexität eines Softwareprojekts wird das schwieriger, und Steuerung und Überblick werden umso wichtiger, um die Qualität des Codes zu sichern. Gerade große Repositories stellen damit neue Herausforderungen, eröffnen zugleich aber auch neue Möglichkeiten für die automatisierte Analyse und Visualisierung von Softwaredaten.
Wir haben daher ein Tool entwickelt, das Repositories von GitHub, GitLab und anderen Quellen im Vergleich zu einer Peer Group analysiert, also mit einer Gruppe inhaltlich ähnlicher Projekte. Entwickelt und getestet haben wir es an über 1.000 Repositories.
Kontext: Die im Folgenden beschriebene Arbeit entstand im Rahmen eines Masterprojekts mit dem Titel „Analysis and Visualization of Similarities in Software Systems“ am Fachgebiet Computergrafische Systeme des Hasso-Plattner-Instituts, gemeinsam mit Robert Schwanhold. Projektpartner war Seerene, ein Startup, das sich mit der Analyse und Verbesserung von Software und Softwareentwicklungsprozessen beschäftigt.
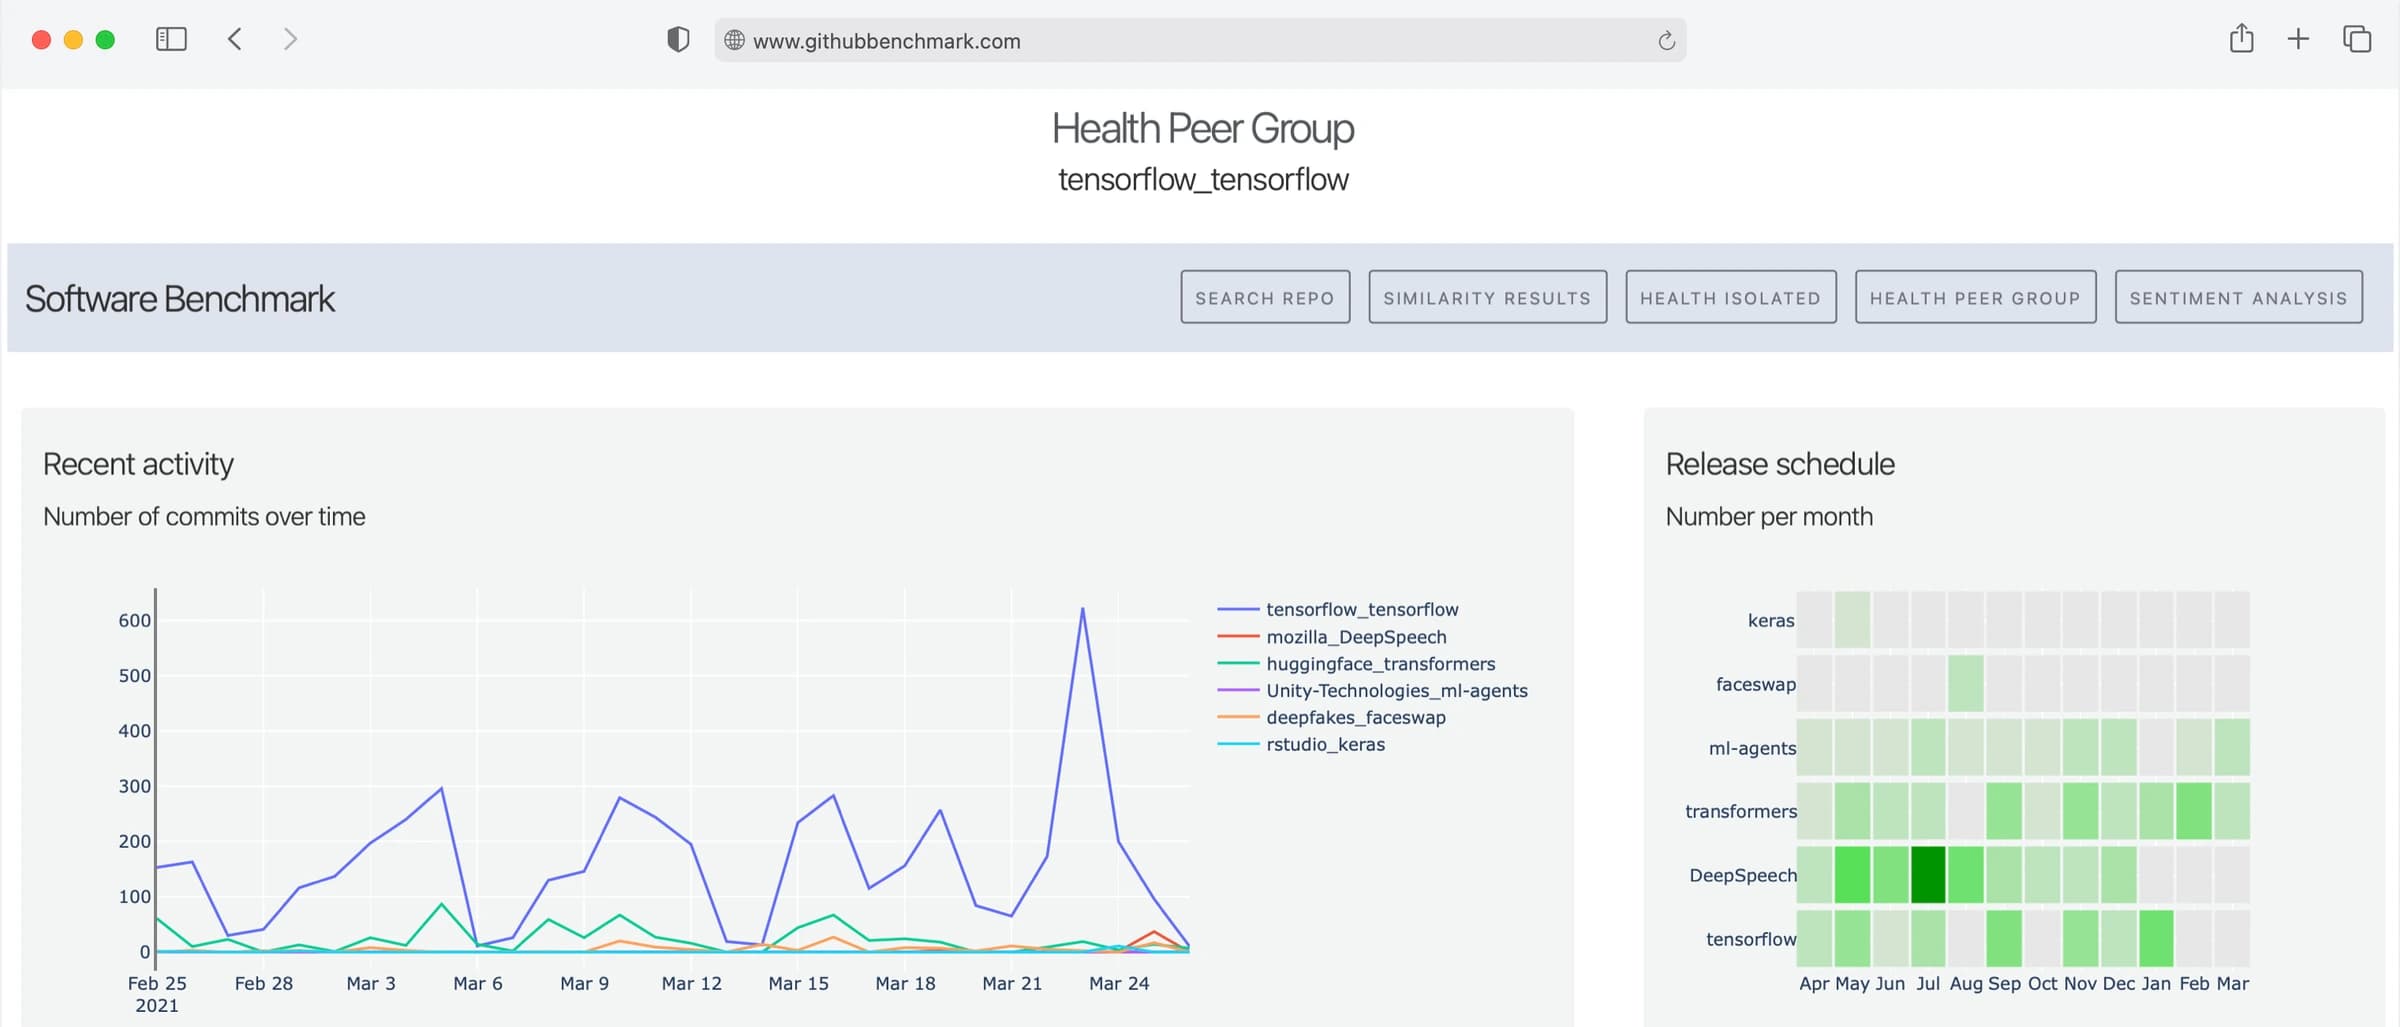
Ein Blick in die finale Anwendung:
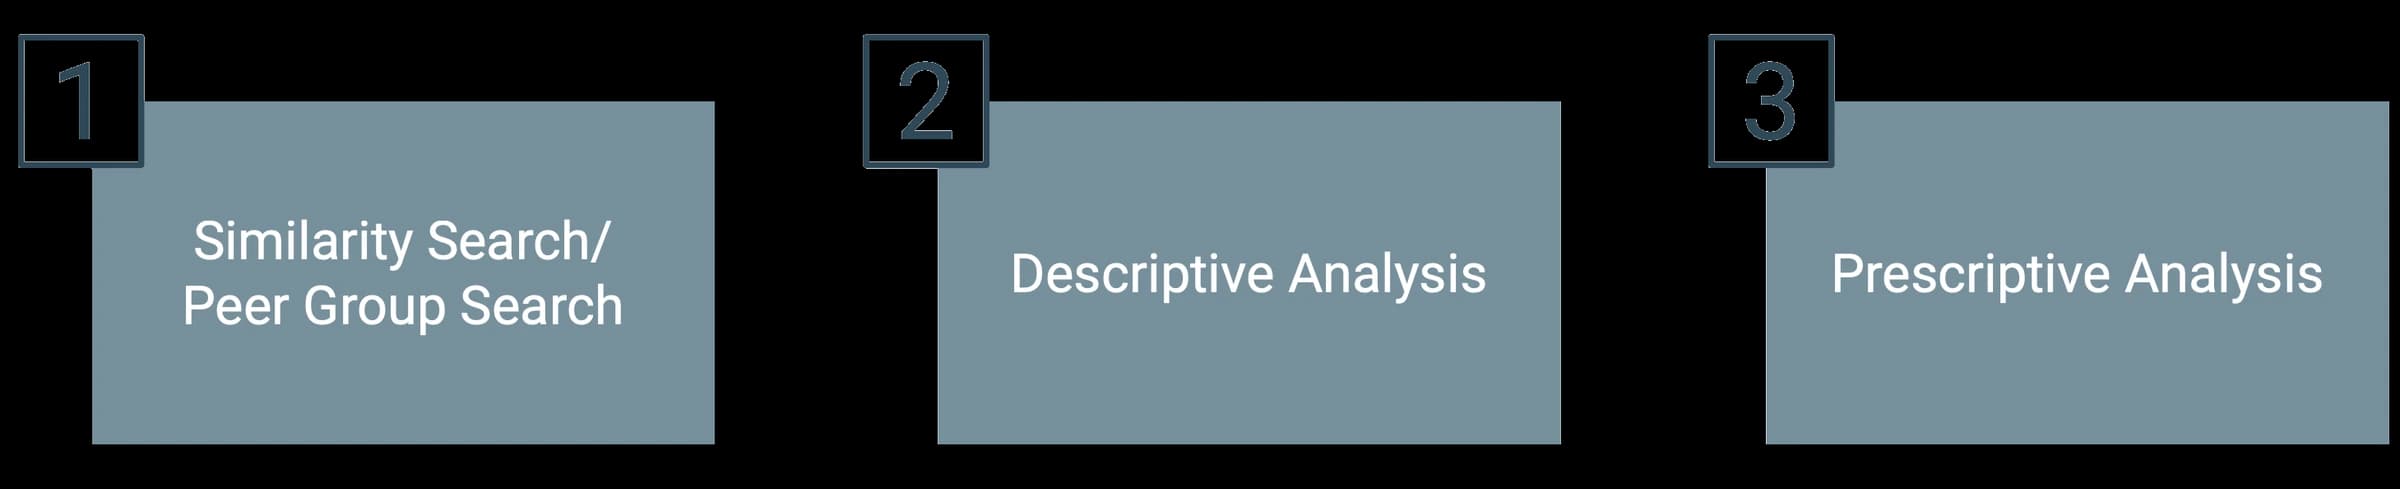
Vorgehen: Unser Ansatz gliedert sich in drei Teile: die Ähnlichkeitssuche (Peer Group Search), die deskriptive und die präskriptive Analyse. Betrachtet haben wir über 1.000 Repositories mit einem Datenvolumen von mehr als 300 GB: die 1.000 meistgestarrten Repositories auf GitHub je Programmiersprache sowie einige selbstausgewählte Projekte.
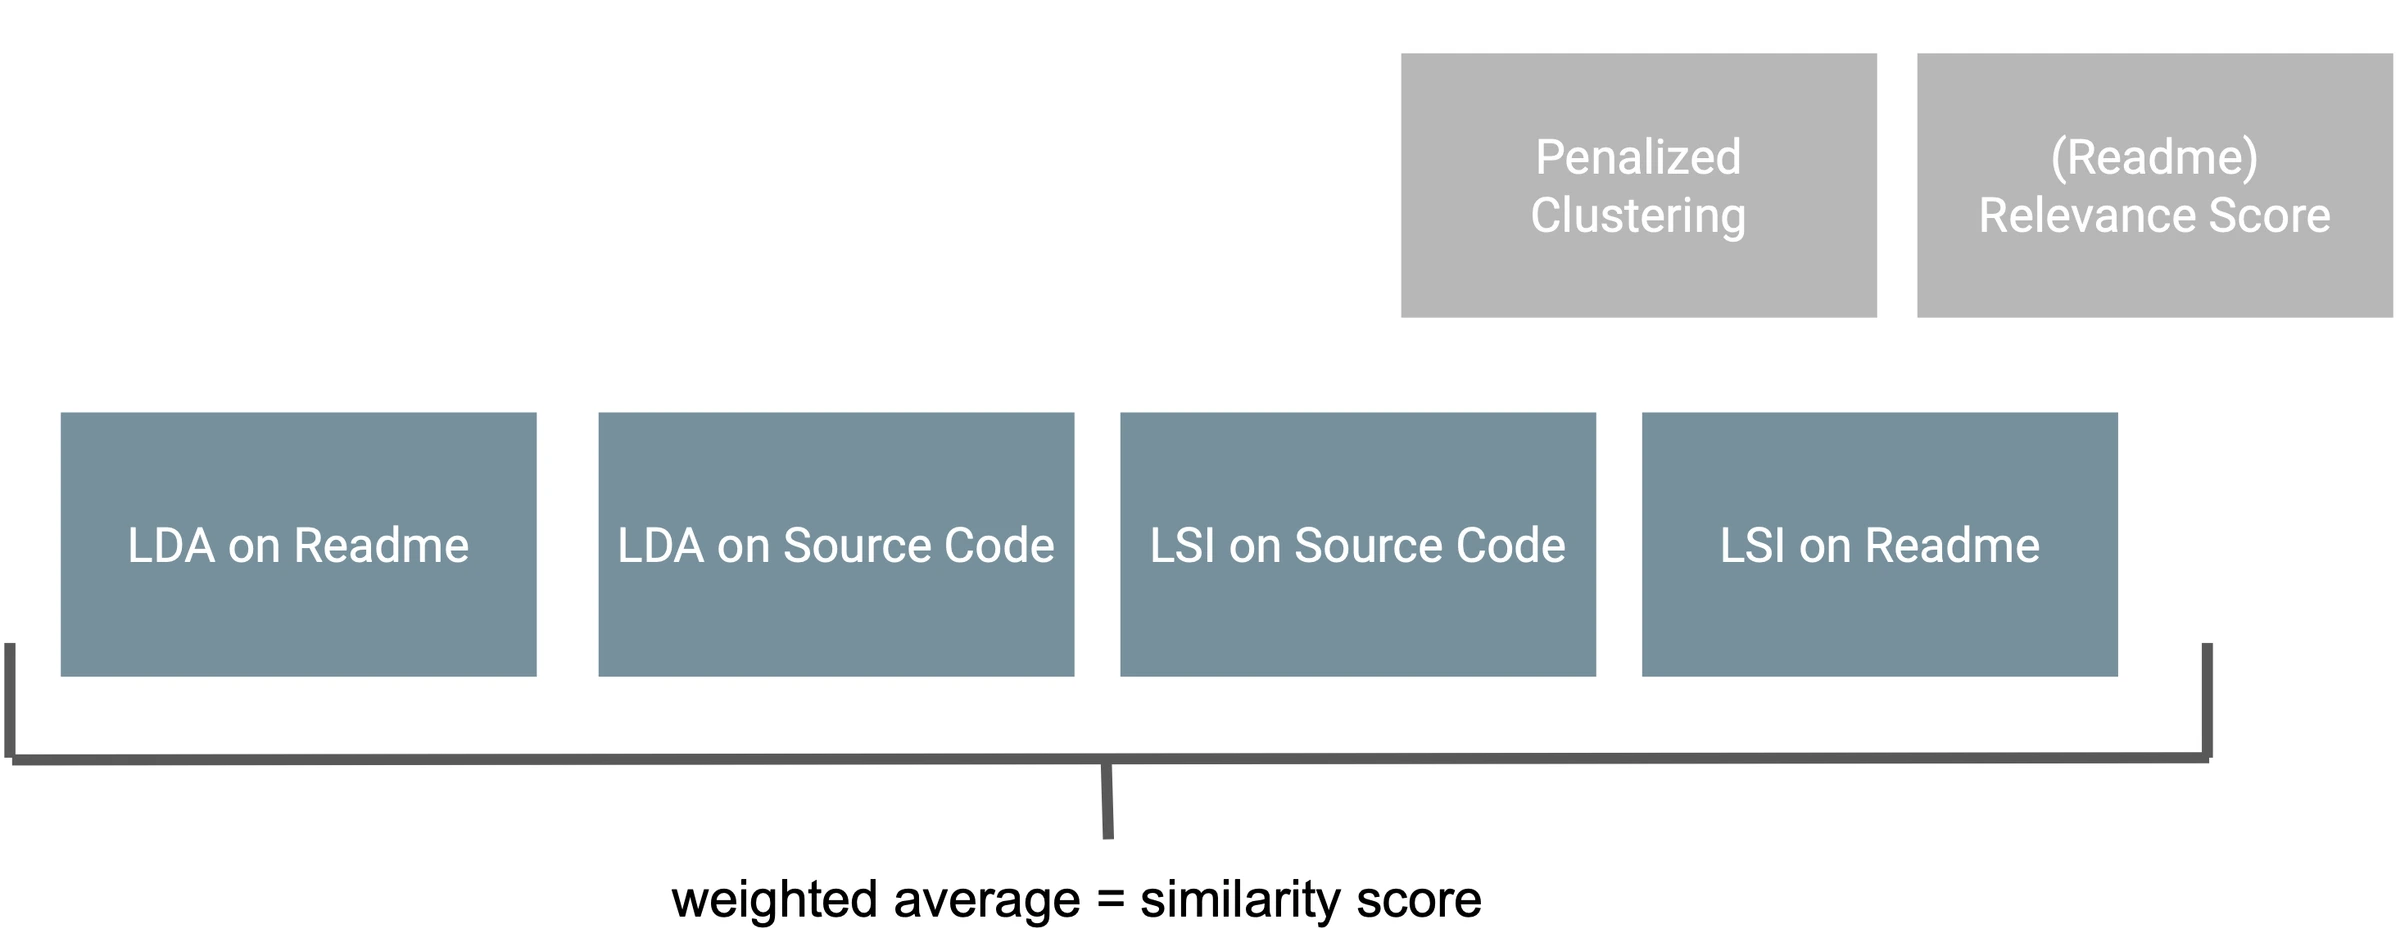
(1) Ähnlichkeitssuche: Um die Ähnlichkeit zweier Repositories zu bestimmen, haben wir sowohl die READMEs (als gute Zusammenfassung des jeweiligen Projekts) als auch den Code der Repos selbst herangezogen. Nach umfangreicher Vorverarbeitung haben wir auf beiden Datenquellen Latent Semantic Indexing beziehungsweise Latent Dirichlet Allocation angewendet, bei dem Code jeweils auf einer Stichprobe der Dateien, um den Rechenaufwand zu begrenzen. Aus den vier so entstandenen Werten haben wir einen gemeinsamen Ähnlichkeitsscore gemittelt.
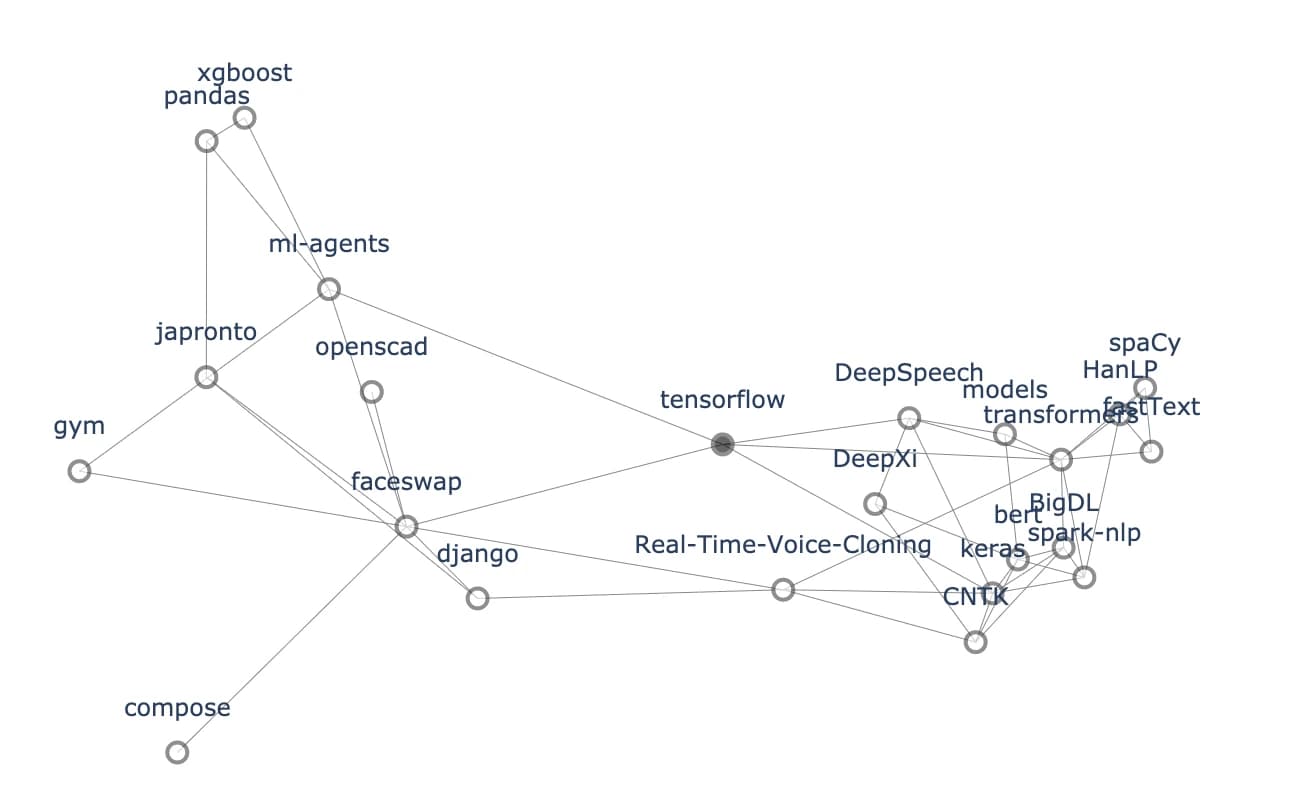
Für die Analyse gibt man lediglich das Repository an, das untersucht werden soll. Um über die unmittelbaren Nachbarn hinaus einen Eindruck vom Umfeld zu vermitteln, stellen wir zusätzlich einen Force-Directed Graph über mehrere Skip Level dar, ausgehend vom Ausgangs-Repository, das durch den dunkleren grauen Punkt markiert ist.
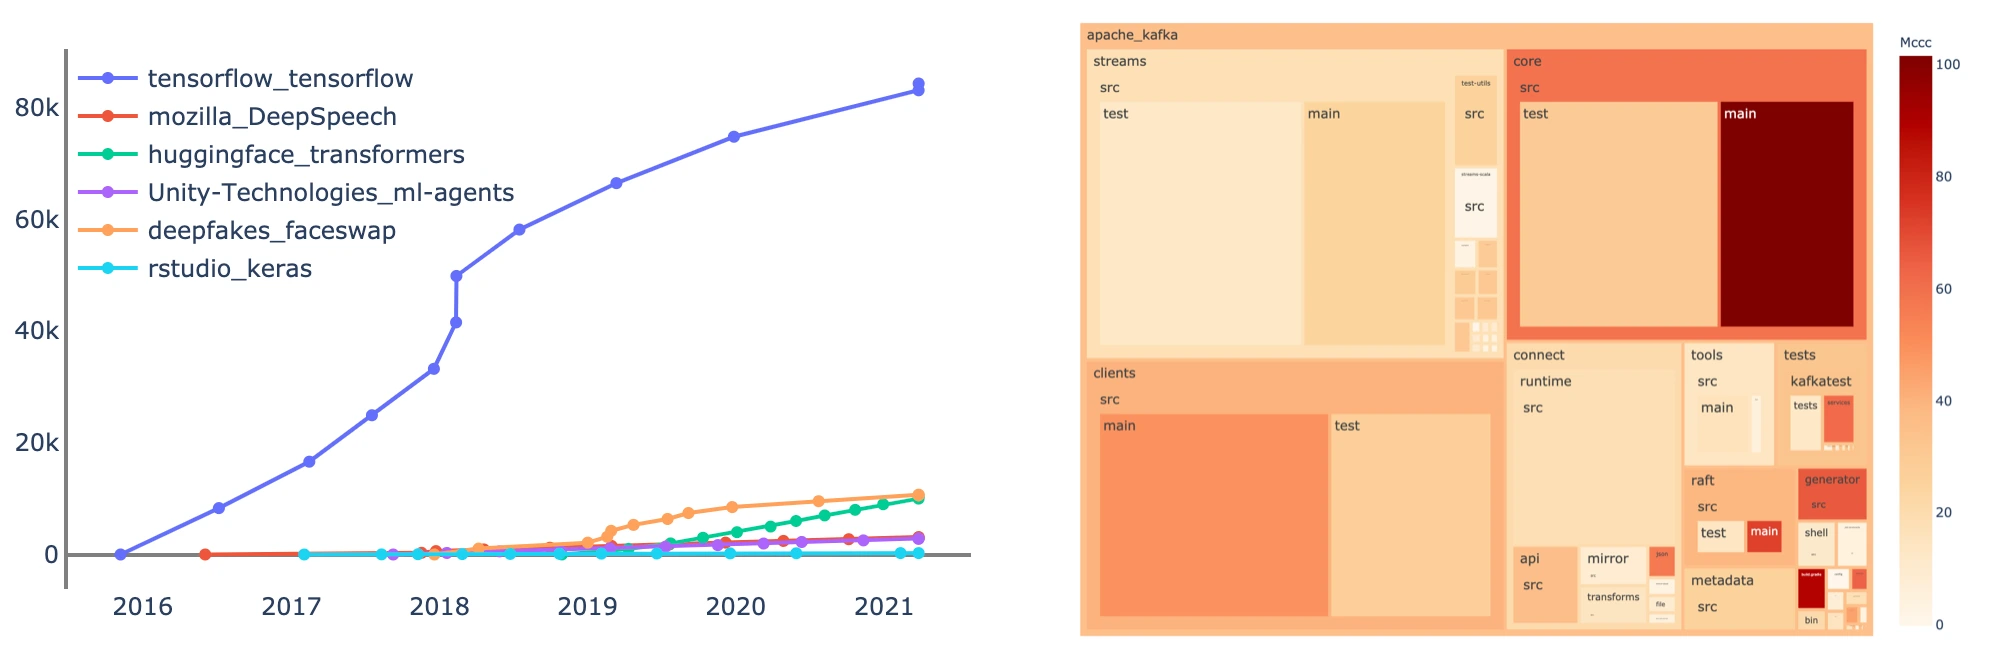
(2) Deskriptive Analyse: Steht die Peer-Gruppe fest, lässt sich das Repository mit den anderen Peers aus der Gruppe vergleichen. Unsere deskriptive Analyse betrachtet unter anderem Stars, Contributions und Forks im Zeitverlauf, den Release-Rhythmus der Projekte sowie die Verteilung von Kommentaren und Codezeilen. Darüber hinaus haben wir eine dynamische Treemap gebaut, deren Farbgebung beispielsweise die zyklomatische Komplexität nach McCabe (McCabe, 1976) über einzelne Dateien oder ganze Bereiche des Repositories abbildet, eine gängige Kennzahl zur Beurteilung von Codekomplexität und der Lesbarkeit von Software.
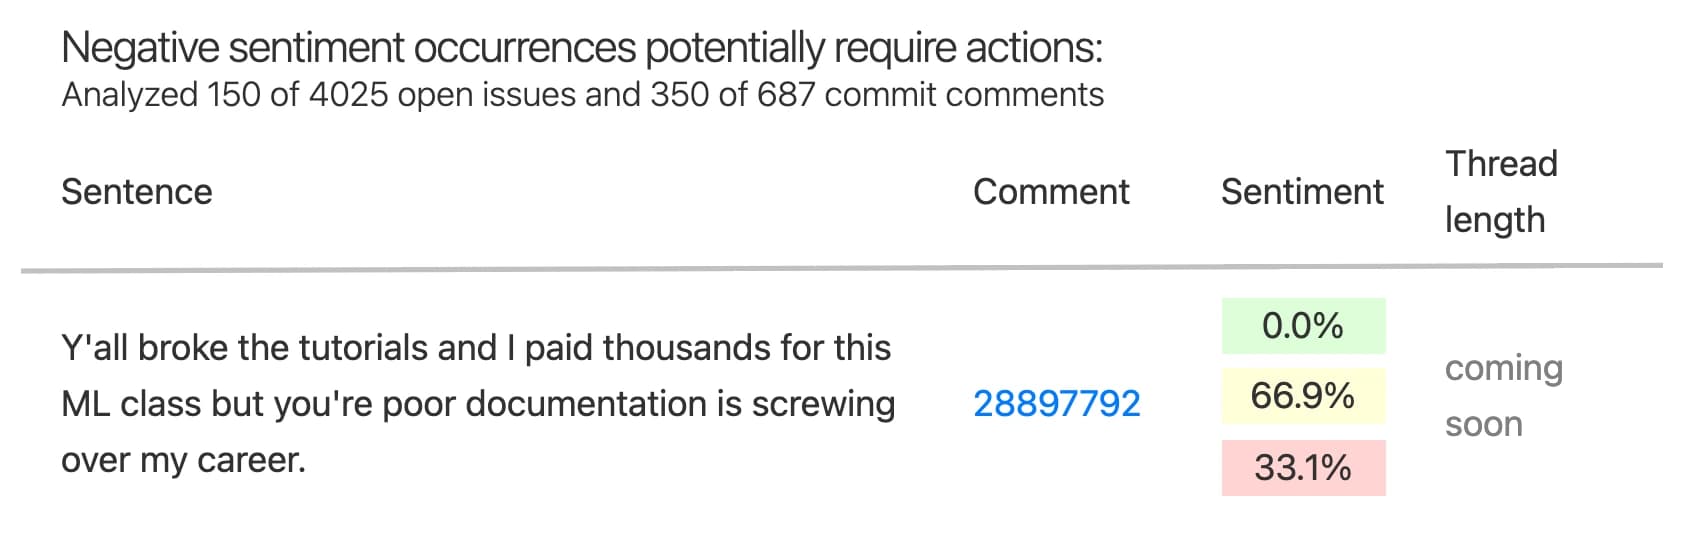
(3) Präskriptive Analyse: In großen Projekten laufen Kommunikation und Zusammenarbeit über PRs, Issues und Kommentare, und genau dort steht auch, wo es gerade klemmt: wer nicht weiterkommt, worüber gestritten wird, welches Thema zu eskalieren droht. Wir haben deshalb eine Sentiment-Analyse auf Commit-Kommentare und die Kommentare offener Issues angewendet. Dafür nutzen wir VADER aus NLTK, ein regelbasiertes Verfahren, das auf Social-Media-Sprache ausgelegt ist. Das passt besser als ein klassisches KI-Modell, das auf normalem Prosatext trainiert ist, weil in Issues ähnlich geschrieben wird: kurz, mit Emojis und viel Interpunktion.
Bewertet wird dabei nicht der ganze Kommentar, sondern jeder Satz einzeln. Ein langer, sachlicher Bugreport mit einem sehr negativen Nebensatz würde sonst im Durchschnitt untergehen. Damit Stacktraces, Logs und Code-Blöcke gar nicht erst in die Sentiment-Analyse geraten, läuft davor ein grober Filter: Ein Satz wird nur bewertet, wenn er mindestens drei Wörter hat, zu über 80 Prozent aus alphanumerischen Zeichen besteht und kein Token länger als 20 Zeichen enthält.
Das folgende Beispiel stammt aus dem TensorFlow-Repository.
Der Stack: Wir haben für das Projekt durchgehend auf Python gesetzt: ein Python-Backend für die Analyse und Flask für die Website, mit Dash für die interaktiven Diagramme, Plotly für die Darstellung und networkx für den Force-Directed Graph.
In der Analyse selbst steckt spaCy für die Lemmatisierung, NLTK für die Stopwörter, gensim für LDA und LSI, dazu scikit-learn und nimfa. Die Repositories wurden mit GitPython geladen, die Metadaten mit PyGithub abgefragt, orchestriert haben wir den Durchlauf mit Metaflow.
Fazit: Das Projekt erstreckte sich über etwa ein Semester, und wir waren nur zu zweit. Andere Masterprojekte wurden von vier bis fünf Personen bearbeitet. Gerade vor diesem Hintergrund bin ich sehr zufrieden mit dem Ergebnis unserer Arbeit. Auch die Zusammenarbeit hat viel Spaß gemacht, trotz der eingeschränkten Möglichkeiten, sich während der Corona-Lockdowns überhaupt zu treffen. Das entstandene Tool reicht von der Datenbeschaffung über die Aufbereitung bis zur Analyse von mehr als 300 GB. Diese Daten bilden den Referenzkorpus: Jedes Repository, das man untersuchen möchte, lässt sich dagegen vergleichen, und das Ergebnis lässt sich in unserer Webanwendung einsehen.