Kausales Strukturlernen
Abstrakt: Ursache-Wirkungs-Beziehungen zu erkennen, ist in vielen Forschungsgebieten ein zentrales Ziel. Interventionen sind in der Praxis oft nicht durchführbar. Daher gibt es verschiedene Techniken und Algorithmen, um kausale Strukturen ausschließlich aus Beobachtungen zu lernen. Der PC-Algorithmus ist ein constraint-basierter Algorithmus zum Lernen kausaler Strukturen, der die zugrundeliegende kausale Struktur beobachteter Variablen mithilfe von Conditional Independence Tests (CI-Tests) ermittelt. Vor dem Hintergrund der stetigen Fortschritte in der Hardwareentwicklung schöpfen rein CPU- oder GPU-basierte parallele Implementierungen des PC-Algorithmus wie pcalg und cuPC die Rechenleistung eines heterogenen Setups (mit GPU und CPU) nicht vollständig aus.
Wir haben uns deshalb mit heterogenem CPU-GPU-Computing für constraint-basiertes kausales Strukturlernen beschäftigt. Hierzu haben wir zwei State-of-the-Art-Implementierungen des PC-Algorithmus evaluiert (pcalg und cuPC) und daraus abgeleitet, wie viel Laufzeit sich einsparen lässt, wenn CPU und GPU gleichzeitig rechnen. Wir schlagen vor, constraint-basiertes kausales Strukturlernen heterogen auszuführen und den Workload statisch aufzuteilen (zu partitionieren). Die Kernidee: Die CI-Tests werden gleichzeitig auf CPU und GPU berechnet, danach führen wir die Ergebnisse zusammen. Dafür haben wir eine Referenzimplementierung auf Basis von pcalg und cuPC erstellt. In unseren Experimenten wird der zusätzliche Overhead mit wachsender Problemgröße vernachlässigbar: Mit unserem Ansatz erreichen wir eine Performance, die mit modernen Implementierungen des PC-Algorithmus vergleichbar ist, und nutzen dabei CPU und GPU gleichzeitig.
Setting: Das Projekt ist im Seminar „Causal Inference – Theory and Applications in Enterprise Computing“ während meines Masterstudiums am Hasso-Plattner-Institut entstanden – gemeinsam mit Tobias Maltenberger, betreut von Christopher Hagedorn und Johannes Huegle.
Die Kausalitätsleiter
Kausale Fragen kann man in drei Arten einteilen – eine Hierarchie, die Judea Pearl „Ladder of Causation“ nennt.
-
1. Assoziation: Beantwortet die Frage, was wir sehen: was uns die Beobachtung von X über Y sagt, ausgedrückt durch P(Y|X). Dafür genügt die gemeinsame Verteilung der beobachteten Variablen, die sich aus Beobachtungsdaten schätzen lässt.
-
2. Intervention: Beantwortet die Frage, was passiert, wenn wir eingreifen – also wie Y reagiert, sobald wir X aktiv auf einen Wert setzen. Geschrieben wird das als P(Y|do(X=x)). Das kann man auf zwei Arten beantworten. Der experimentelle Weg führt über einen Randomized Controlled Trial, der oft aus Kosten- oder ethischen Gründen nicht vertretbar ist (z.B. Menschen zufällig zum Rauchen zu zwingen). Für den Beobachtungs-Weg benötigt man den Kausalgraphen G zusammen mit einer Reihe von Annahmen (keine unbeobachteten Confounder, Positivity und weitere Annahmen). Möglich macht den Beobachtungs-Weg ein Causal Graphical Model, also ein DAG zusammen mit der bedingten Verteilung jeder Variable gegeben ihre Parents. Der Graph hält fest, welche Variable welche direkt beeinflusst. Das do-Kalkül beantwortet dann die Frage der Identifikation: ob sich P(Y|do(X=x)) als Funktional der beobachteten Verteilung P schreiben lässt – und wenn ja, als welches.
-
3. Counterfactuals: Beantwortet die Frage, was stattdessen gewesen wäre: welchen Wert Y für eine konkrete Beobachtungseinheit angenommen hätte, wenn X einen anderen Wert angenommen hätte – gegeben das, was wir tatsächlich beobachtet haben. Dafür benötigen wir das vollständige Structural Causal Model (SCM), also einen DAG mitsamt den funktionalen Zusammenhängen und den Verteilungen der Noise Terms. Jede Variable entsteht aus einer Gleichung Vᵢ = fᵢ(Parents, Uᵢ), wobei der Noise Term Uᵢ alles abdeckt, was eine einzelne Beobachtungseinheit ausmacht und vom Modell nicht erklärt wird. Beantworten lässt sich die Frage dann in drei Schritten: Abduction bestimmt aus der tatsächlichen Beobachtung die Noise Terms dieser Beobachtungseinheit, Action setzt X auf den anderen Wert, Prediction berechnet Y neu – das ergibt P(Y_x | X = x', Y = y').
Um die Begriffe korrekt zu unterscheiden: Die statistische Inferenz sitzt auf Ebene 1 der Kausalitätsleiter und beantwortet Fragen über die Welt, wie sie ist, während die kausale Inferenz auf Ebene 2 und 3 sitzt und Fragen über eine Welt beantwortet, in die wir eingreifen, oder über eine Welt, wie sie hätte sein können.
Wie man eine kausale Struktur aus Daten lernt
Ein Causal Graphical Model stellt kausale Beziehungen als Directed Acyclic Graph (DAG) dar: Jeder Knoten ist eine Zufallsvariable, und eine gerichtete Kante von einem Knoten zum anderen bedeutet, dass die erste Zufallsvariable eine direkte Ursache der zweiten ist. Kausales Strukturlernen heißt, diesen Graphen aus Daten zu rekonstruieren.
Constraint-basierte Algorithmen gehen dabei nach dem Ausschlussprinzip vor. Sie starten mit einem fully-connected Graphen und prüfen für jedes Variablenpaar, ob die beiden statistisch unabhängig sind, sobald eine Menge weiterer Variablen berücksichtigt wird – ein Conditional Independence Test, kurz CI-Test. Sind sie es, kann die Kante zwischen ihnen keine direkte Ursache abbilden und fällt weg. Was nach allen Tests übrig bleibt, ist das ungerichtete Skeleton des Graphen; in einem zweiten Schritt werden die verbleibenden Kanten mit deterministischen Regeln orientiert.
Constraint-basiertes kausales Strukturlernen beruht auf drei Annahmen:
- Causal Markov Condition: G und P erfüllen die Causal Markov Condition genau dann, wenn jeder Knoten von G unabhängig von allen seinen Non-Descendants ist, gegeben all seiner Parents.
- Causal Faithfulness Condition: G und P erfüllen die Causal Faithfulness Condition genau dann, wenn bedingte Unabhängigkeit (Conditional Independence) ausschließlich aus der Causal Markov Condition folgt.
- Causal Sufficiency Condition: Causal Sufficiency gilt, wenn alle gemeinsamen Ursachen der beobachteten Variablen in den Daten enthalten sind.
Die Markov Condition besagt, dass jede bedingte Unabhängigkeit, die G impliziert, auch in P gilt; Faithfulness besagt umgekehrt, dass G jede Unabhängigkeit impliziert, die in P gilt. Zusammen stellen die beiden Bedingungen sicher, dass die bedingten Unabhängigkeiten in P genau die sind, die G impliziert – und erst dadurch lässt sich aus einem CI-Test auf das Fehlen einer Kante schließen. Unter diesen Annahmen identifizieren die CI-Tests die Markov-Äquivalenzklasse des wahren DAG und nicht den DAG selbst.
Der bekannteste Algorithmus dieser Familie ist der PC-Algorithmus. Die erste Phase des Algorithmus – die Adjacency Search – ist in Levels gegliedert. Auf Level l wird Unabhängigkeit bedingt auf Separation Sets der Größe l getestet. Level 0 fragt nach Unconditional Independence – ob zwei Variablen unabhängig sind, ohne auf irgendetwas zu bedingen (X ⫫ Y) –, Level 1 bedingt auf eine einzelne weitere Variable (X ⫫ Y | Z) und so weiter. Nach jedem Level werden die als unabhängig erkannten Kanten entfernt, was den Aufwand für alle folgenden Levels reduziert.
Für unsere Arbeit sind zwei Eigenschaften entscheidend. Erstens dominiert die Adjacency Search die Laufzeit fast vollständig, weshalb sich alle Optimierungen auf die Adjacency Search richten. Zweitens ist der ursprüngliche PC-Algorithmus order-dependent: Das Ergebnis hängt davon ab, in welcher Reihenfolge die Variablen vorliegen, und das verhindert eine parallele Ausführung. PC-stable (Colombo & Maathuis, 2014) löst das mit einer order-independent Variante, in der Kantenlöschungen für die übrigen Tests desselben Levels unsichtbar bleiben – und erst diese Order-Independence macht das Verfahren überhaupt parallelisierbar.
Zwei parallele Implementierungen bilden hier den State of the Art:
- pcalg (Kalisch et al., 2012) ist die Referenzimplementierung des PC-Algorithmus und das Package, auf dem ein Großteil der Causal-Discovery-Arbeiten aufbaut – ein R-Package mit C++-Kern, das die CI-Tests eines Levels mit OpenMP parallel auf allen CPU-Kernen ausführt. Die Implementierung liegt auf CRAN.
- cuPC (Zarebavani et al., 2019) ist die schnellste veröffentlichte Implementierung und setzt PC-stable in CUDA für die GPU um. Dazu kommen GPU-spezifische Optimierungen: Die Adjazenzmatrix wird zwischen den Levels verdichtet, Ergebnisse von Tests mit gemeinsamem Separation Set werden wiederverwendet, häufig benötigte Daten liegen im Shared Memory, und sobald eine Kante entfernt ist, brechen die übrigen Threads vorzeitig ab. Zusammen machen diese Optimierungen cuPC um Größenordnungen schneller als pcalg. Den Quellcode gibt es auf GitHub.
Heterogenes Computing – Herausforderungen und Chancen
CPUs sind darauf optimiert, sequenziellen Code effizient abzuarbeiten (via Branch Prediction, tiefe Cache-Hierarchien und spekulative Ausführung). GPUs sind auf hochparallele arithmetische Operationen auf Hunderten oder Tausenden von Kernen optimiert. Heterogenes Computing ist die Idee, beide Processing Units (PU) gleichzeitig zu nutzen, statt sich auf eine zu beschränken. In einem GPU-beschleunigten Programm ist die CPU meist idle und startet nur Kernel.
Eine zweite PU einzubinden, kostet allerdings an mehreren Stellen: Der Workload muss partitioniert werden, die Tasks müssen den beiden PUs zugewiesen werden, und die Ergebnisse müssen anschließend synchronisiert werden. Partitionierungsstrategien im heterogenen Setting lassen sich in statische und dynamische Strategien trennen.
- Statisches Workload-Partitioning: Eine statische Strategie legt vor der Ausführung fest, welche Tasks auf welcher PU laufen, und berücksichtigt die Eigenschaften der Hardware nicht. Sie bringt wenig Overhead mit sich, ist aber anfällig für Load Imbalance (Kantenlöschungen verteilen sich zum Beispiel nicht gleichmäßig auf die Partitionen).
- Dynamisches Workload-Partitioning: Eine dynamische Strategie passt die Aufteilung zur Laufzeit an. Das verursacht mehr Overhead, fängt eine mögliche Load Imbalance aber ein.
Beim constraint-basierten kausalen Strukturlernen kann man auf Knotenebene partitionieren (alle CI-Tests für alle Kanten einer Variable werden auf einer PU berechnet), auf Kantenebene (alle CI-Tests einer Kante werden auf einer PU berechnet) oder auf CI-Test-Ebene (die CI-Tests einer einzelnen Kante verteilen sich auf beide PUs).
Laufzeitverhalten der Adjacency Search
Bevor wir den Workload aufgeteilt haben, haben wir uns die Laufzeit der Adjacency Search angesehen. Als Baseline haben wir mit cuPC die schnellere der beiden Implementierungen genommen, mit randomDAG() aus pcalg synthetische Daten erzeugt (so war der Ground-Truth-Graph bekannt) und die Parameter einzeln variiert.
Drei Parameter treiben die Laufzeit stark nach oben: die Anzahl der Variablen n, die Edge Probability p des zugrundeliegenden Graphen und das Signifikanzniveau α. Ein größeres α entfernt in den frühen Levels weniger Kanten, und somit bleiben mehr Tests für die späteren Levels übrig. Die Anzahl der Samples m hat dagegen kaum Einfluss, weil der CI-Test für multivariat normalverteilte Daten anhand der Korrelationsmatrix berechnet wird und nicht anhand der Samples selbst.
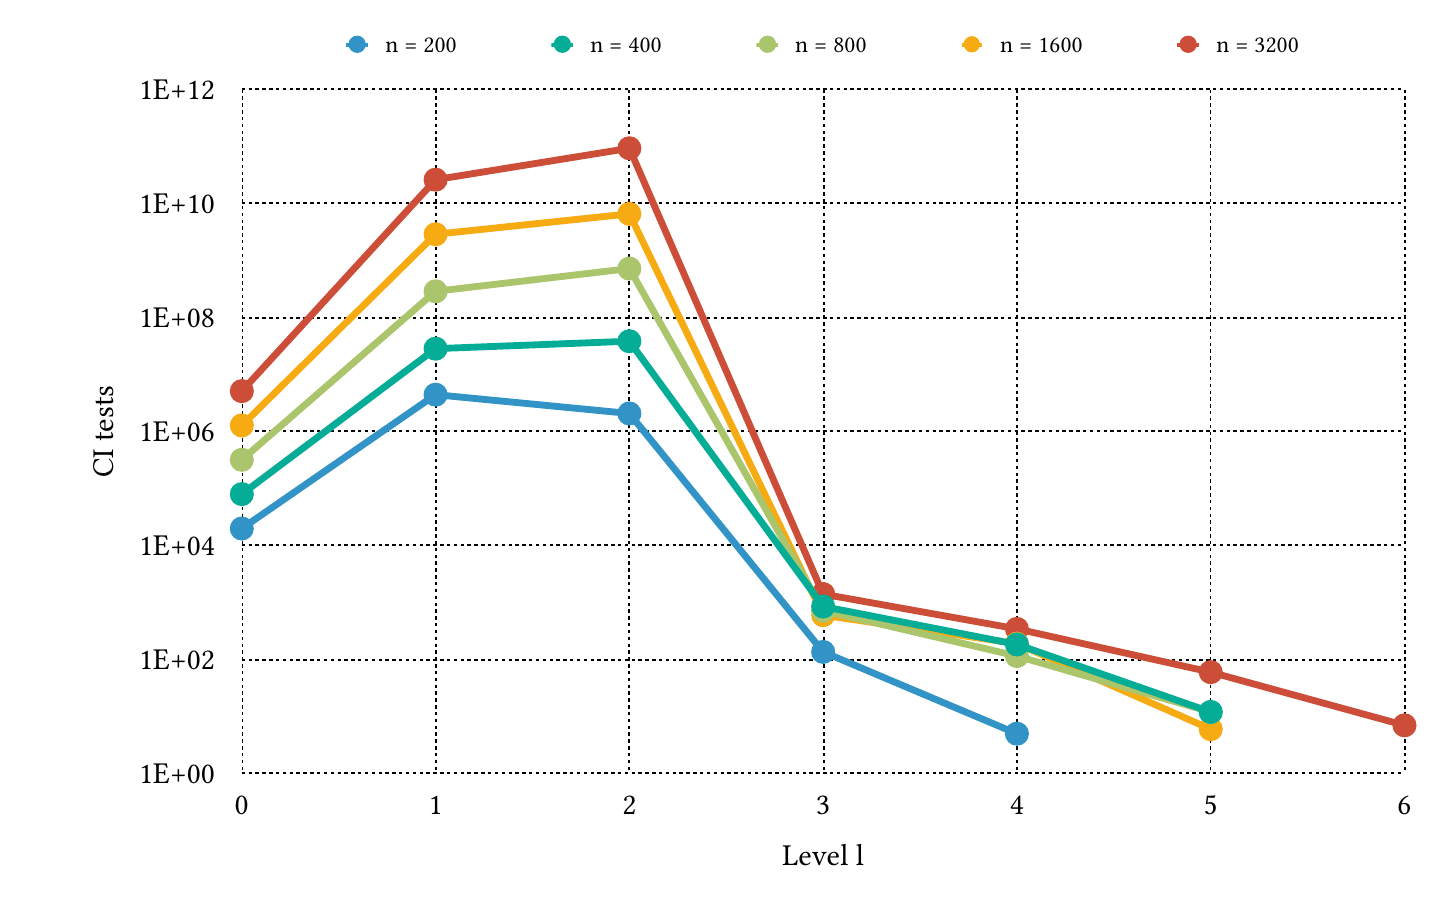
Wichtiger als die einzelnen Parameter ist, wie sich die Laufzeit auf die Levels verteilt. Die Zahl der CI-Tests ist auf Level 1 und 2 am größten, und allein diese zwei Levels machen über 90% der Gesamtlaufzeit aus.
Anschließend haben wir die Auslastung der GPU pro Level mit der Metrik sm_efficiency via nvprof gemessen. cuPC nutzt pro Level einen eigenen CUDA-Kernel, die Messung benötigt also keine weitere Instrumentierung:
| Level l | n = 200 | n = 400 | n = 800 | n = 1600 | n = 3200 |
|---|---|---|---|---|---|
| 0 | 16,75% | 36,34% | 74,33% | 90,87% | 97,46% |
| 1 | 90,52% | 90,45% | 91,55% | 94,45% | 98,92% |
| 2 | 45,96% | 51,69% | 36,91% | 35,83% | 100,00% |
| 3 | 22,16% | 29,07% | 34,89% | 35,52% | 49,49% |
| 4 | 2,92% | 12,80% | 16,04% | 14,79% | 28,94% |
| 5 | – | 3,54% | 4,73% | 5,73% | 13,49% |
| 6 | – | – | – | – | 9,35% |
GPU-Auslastung pro Level (m = 6400, p = 0,2, α = 0,05). In Fett sind die Werte über 90%.
Ab 1.600 Variablen lasten die ersten drei Levels die GPU aus, bei 3.200 Variablen erreicht Level 2 die volle Auslastung. top und mpstat zeigen für dieselben Läufe, dass die CPU im Leerlauf bleibt. Eine PU ist ausgelastet, die andere ungenutzt – und das auf genau den Levels, die den Großteil der Laufzeit ausmachen. Daraus ist die Motivation für unseren heterogenen Ansatz entstanden.
Die Adjacency Search auf beide PUs aufteilen
Unser Ansatz führt einen Teil der CI-Tests jedes Levels auf der GPU aus und die übrigen gleichzeitig auf der CPU.
Wir partitionieren statisch auf Knotenebene. Die CI-Tests einer einzelnen Kante auf beide PUs zu verteilen, würde genau den Overhead verursachen, den cuPC für die Parallelisierung innerhalb einer Kante bereits beschreibt: redundante Tests und Synchronisation mitten in einer Arbeitseinheit, die ungeteilt bleiben sollte. Da der Ansatz auf große Graphen abzielt (ab etwa 1.600 Variablen), ist ein einzelner Knoten nur ein kleiner Teil der Gesamtarbeit – die Aufteilung auf Knotenebene ist damit fein genug, um die Last zwischen CPU und GPU gleichmäßig zu verteilen.
Der Partitioning Factor pf steuert den Anteil der Knoten, deren CI-Tests auf der CPU berechnet werden. Die ersten n × pf Zeilen und Spalten der Adjazenzmatrix werden auf der CPU getestet, die restlichen n × (1 − pf) auf der GPU. pf steht vor der Ausführung fest und bleibt über alle Levels hinweg konstant.
Jedes Level läuft dann in drei Phasen:
- Die CI-Tests auf Knotenebene nach pf partitionieren.
- Sie gleichzeitig auf beiden PUs ausführen – jede arbeitet auf ihrer eigenen Submatrix und parallelisiert intern.
- Die beiden teilweise aktualisierten Submatrizen zu einer Adjazenzmatrix zusammenführen, bevor das nächste Level startet.
Implementierung
Unsere Referenzimplementierung kombiniert pcalg und cuPC: die CPU-Seite kommt aus pcalg, die GPU-Seite aus cuPC. Wir haben die Adjacency Search und den CI-Test aus dem C++-Kern von pcalg herausgezogen, die R-Bindings entfernt und das Ergebnis in die CUDA-Quellen von cuPC eingebettet. Der Code liegt auf GitHub.
Vier Details der Implementierung sind erwähnenswert:
Speicher. Auf CPU-Seite liegt der Graph in einer Struktur der Boost Graph Library, einer etablierten C++-Bibliothek, die sowohl Datenstrukturen als auch die gängigen Graphalgorithmen bereitstellt. Auf GPU-Seite wird alles, was nur die GPU nutzt – die Separation Sets und die Hilfsstrukturen für die Kantenorientierung – mit cudaMalloc allokiert, während die GPU-Repräsentation des Graphen cudaMallocManaged verwendet. Managed Memory legt den Graphen in einen gemeinsamen virtuellen Adressraum, auf den CPU und GPU direkt zugreifen können, ohne ihn vorher zu kopieren, und überträgt via Demand Paging nur die Pages, die sich tatsächlich geändert haben. Die Alternative (reines cudaMalloc plus explizites cudaMemcpy in einen Host-Buffer und zurück) hat im Benchmark für große n kaum einen Unterschied gemacht, also haben wir die Managed-Variante behalten, da hier die Programming Experience besser ist.
Nur die Differenzen zusammenführen. Aus dem Host-Thread in Managed GPU Memory zu lesen und zu schreiben, ist teuer. Die Merge-Phase propagiert deshalb nur die Kanten, die hinzugefügt (Level 0) oder gelöscht wurden (alle späteren Levels), statt ganze Submatrizen zu kopieren. In den Levels, die wenige Kanten entfernen, kostet das Zusammenführen damit kaum etwas.
CPU-Threads voll auslasten. Der CPU-Thread sammelt die Kanten seiner Partition und führt deren CI-Tests mit OpenMP auf t Threads parallel aus, wobei t ungefähr der Kernzahl entspricht. In den höheren Levels kann die Zahl der verbleibenden Kanten k unter t fallen, sodass Threads leer laufen würden. Für diesen Fall haben wir eine zweite Parallelisierungsebene eingezogen, via Armadillo – der wissenschaftlichen C++-Bibliothek, auf der unsere CI-Tests auf CPU-Seite laufen. So verteilen sich die CI-Tests einer einzelnen Kante auf die übrigen Threads.
Vergleichbarkeit. pcalg und cuPC werten CI-Tests nach verschiedenen Kriterien aus: pcalg vergleicht die Fisher-z-transformierte partielle Korrelation direkt mit dem Signifikanzniveau α, während cuPC daraus einen Schwellwert τ pro Level ableitet. Innerhalb eines Levels würden CPU- und GPU-Partition damit unterschiedlich testen, weshalb wir die CPU-Seite ebenfalls auf τ umgestellt haben.
Ergebnisse
Alle Messungen haben wir auf einem Bare-Metal-Server durchgeführt: zwei Intel Xeon Gold 6148 CPUs (je 20 Kerne, 2 Threads pro Kern) mit 750 GB RAM sowie vier NVIDIA Tesla V100-SXM2 GPUs mit 32 GB High-Bandwidth Memory, verbunden via PCIe Generation 3. Jedes Experiment haben wir 100-mal wiederholt und die Laufzeiten gemittelt.
Der Overhead, den der Ansatz verursacht, setzt sich aus der Speicherallokation auf CPU-Seite, dem abschließenden Transfer zurück nach R und einer Merge-Phase pro Level zusammen. Alle drei wachsen linear mit der Anzahl der Variablen, während die Kosten der CI-Tests sehr viel schneller steigen. Der Overhead sollte mit wachsender Problemgröße also an Bedeutung verlieren:
| Variablen n | Heterogen [s] | cuPC [s] | Differenz |
|---|---|---|---|
| 1600 | 3,29 | 1,82 | 80,53% |
| 1800 | 4,62 | 2,64 | 74,66% |
| 2000 | 5,91 | 3,62 | 63,06% |
| 2200 | 8,50 | 5,56 | 52,79% |
| 2400 | 19,35 | 15,22 | 27,14% |
| 2600 | 18,68 | 13,96 | 33,85% |
| 2800 | 24,46 | 18,97 | 28,93% |
| 3000 | 47,93 | 39,50 | 21,36% |
| 3200 | 43,72 | 34,97 | 25,02% |
Gesamtlaufzeit im Vergleich zu cuPC (m = 6400, p = 0,2, α = 0,05, pf = 0,05). Die Differenz ist die zusätzliche Laufzeit der heterogenen Variante gegenüber cuPC. Jeder Zeile liegt ein eigener, mit randomDAG() erzeugter Graph zugrunde, weshalb die Laufzeiten nicht streng monoton in n sind. pcalg haben wir nicht zum Vergleich herangezogen, da es um Größenordnungen langsamer als cuPC ist.
Bei 1.600 Variablen benötigt die heterogene Variante 80% mehr Laufzeit als cuPC, fast ausschließlich Merge-Overhead. Bei 3.200 Variablen sind daraus 25% geworden. Die heterogene Variante bleibt über den gesamten gemessenen Bereich langsamer als cuPC, aber der Abstand schrumpft mit wachsender Problemgröße (bei linear wachsendem Overhead zu erwarten). An seinem oberen Ende erreicht der Ansatz eine Performance, die mit dem reinen GPU-Lauf vergleichbar ist, während ein Teil der Arbeit auf einer PU läuft, die vorher im Leerlauf war.
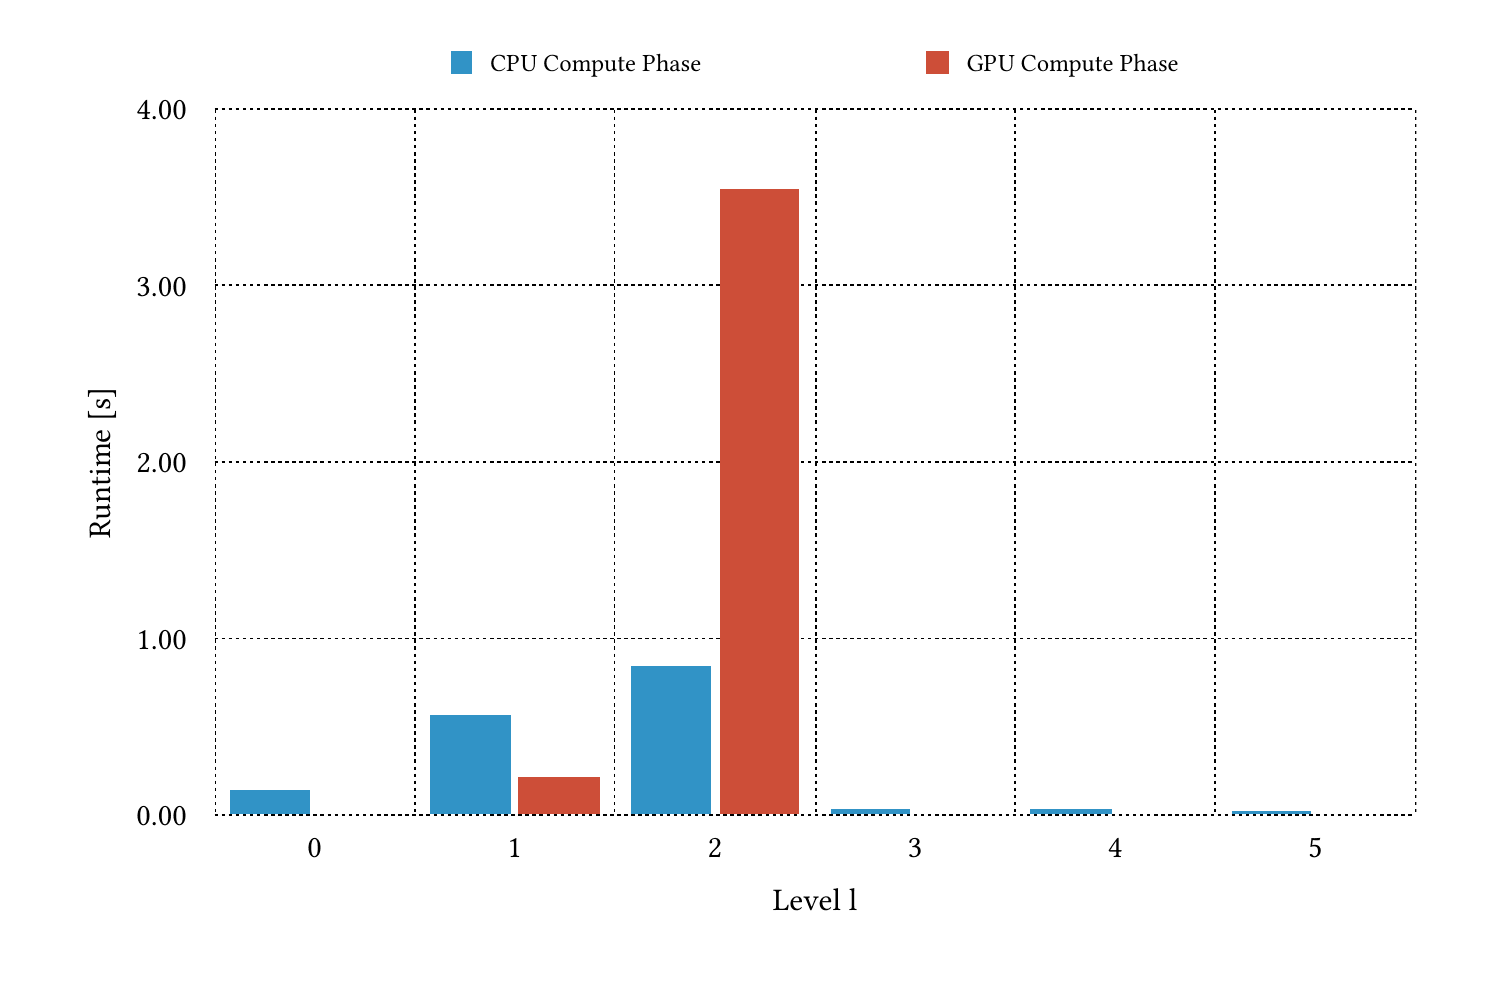
Der größte Nachteil unseres Ansatzes ist die statische Partitionierung der Arbeit. Bei pf = 0,09 bekommt die CPU auf manchen Levels zu viel Arbeit und auf anderen zu wenig. Auf Level 0 laufen sehr viele unabhängige CI-Tests ohne Synchronisation dazwischen, das eignet sich gut für die GPU. pf = 0,09 gibt der CPU dort also mehr Arbeit, als sie bewältigen kann. Auf Level 1 ist die CPU die langsamere der beiden und die GPU wartet. Auf Level 2 benötigt die GPU beim selben Faktor 3,54 Sekunden gegenüber 0,84 Sekunden auf der CPU. Ein einzelner konstanter Wert kann nicht allen Levels gerecht werden: Die Kosten eines CI-Tests unterscheiden sich je Level, und Kantenlöschungen verteilen sich nicht gleichmäßig auf die beiden Partitionen, sodass eine gewisse Load Imbalance bleibt.
Diskussion und Ausblick
Unsere experimentelle Evaluation zeigt, dass unser Ansatz für den Adjacency Search in einem heterogenen Setting funktioniert. Wir erreichen dabei eine Performance, die mit der ursprünglichen Implementierung von cuPC vergleichbar ist und sowohl GPU als auch CPU nutzt.
Der nächste Schritt ist eine dynamische Partitionierungsstrategie, die den Faktor pro Level neu berechnet – aus den Kosten eines CI-Tests auf diesem Level, der relativen Rechenleistung beider PUs, dem Interconnect dazwischen und daraus, wie ungleichmäßig sich die Kantenlöschungen auf die beiden Partitionen verteilen. Dazu zwei kleinere Erweiterungen: einzelne Levels ausschließlich auf einer PU rechnen, was sich für die späten Levels auszahlen dürfte, in denen so wenige CI-Tests übrig sind, dass die Merge-Phase mehr kostet als die Aufteilung einspart; und die CUDA-Block-Sizes pro Level festlegen, statt die statischen von cuPC zu übernehmen, um Leerlauf in nicht ausgelasteten Kernel-Threads zu reduzieren.
Paper: Unser Ansatz, unsere Messungen im Detail sowie der theoretische Hintergrund und der Stand der Forschung finden sich in voller Länge im Paper, das als Abschlussarbeit des Seminars gemeinsam mit Tobias Maltenberger entstanden ist: Heterogeneous Computing for Constraint-based Causal Structure Learning (PDF).