Histopathologische Krebserkennung mit Deep Learning
Abstrakt: Bei der Früherkennung, der Bestimmung des Krankheitsstadiums (Staging) und der Therapie von Krebs kommt der Histopathologie (der mikroskopischen Untersuchung von Gewebe) eine zentrale Rolle zu. Ein wichtiges Verfahren ist dabei die Sentinel-Lymphknoten-Biopsie. Hierbei wird der Lymphknoten, den ein Tumor als erstes erreicht, entnommen und untersucht. Für die digitale Auswertung wird die gesamte Gewebeprobe in hoher Auflösung fotografiert und anschließend von Pathologen ausgewertet.
Für Pathologen ist es zeitaufwändig, repetitiv und oft auch schwierig, die Gewebeproben zu untersuchen und bösartiges von gutartigem Gewebe zu unterscheiden. Deep-Learning-Ansätze haben in der digitalen Histopathologie in den letzten Jahren stark an Bedeutung gewonnen und versprechen hohe Genauigkeit, mehr Objektivität und Effizienz. Deshalb haben wir verschiedene state-of-the-art Deep-Learning-Architekturen für diese Aufgabe systematisch verglichen.
In unserer Arbeit haben wir VGGNets, ResNets und DenseNets auf dem PCam-Datensatz verglichen, der 220.025 Bildausschnitte (Patches) von Lymphknotengewebe enthält. Als Zielmetrik haben wir AUROC (Area Under the ROC Curve) verwendet. Anders als Accuracy kommt sie mit ungleich verteilten Klassen zurecht und hängt nicht davon ab, ab welcher Wahrscheinlichkeit wir einen Patch als bösartig werten. Die Stain Normalization, also das Angleichen der Färbung der Gewebeproben, hat die Ergebnisse nicht verbessert. Die besten Modelle haben eine AUROC von über 99 % erreicht, allen voran ein vortrainiertes ResNet34 mit 99,53 %. Convolutional Neural Networks eignen sich also gut, um Krebs in Lymphknotengewebe zu erkennen. Pathologen könnten sie im Arbeitsalltag durchaus unterstützen.
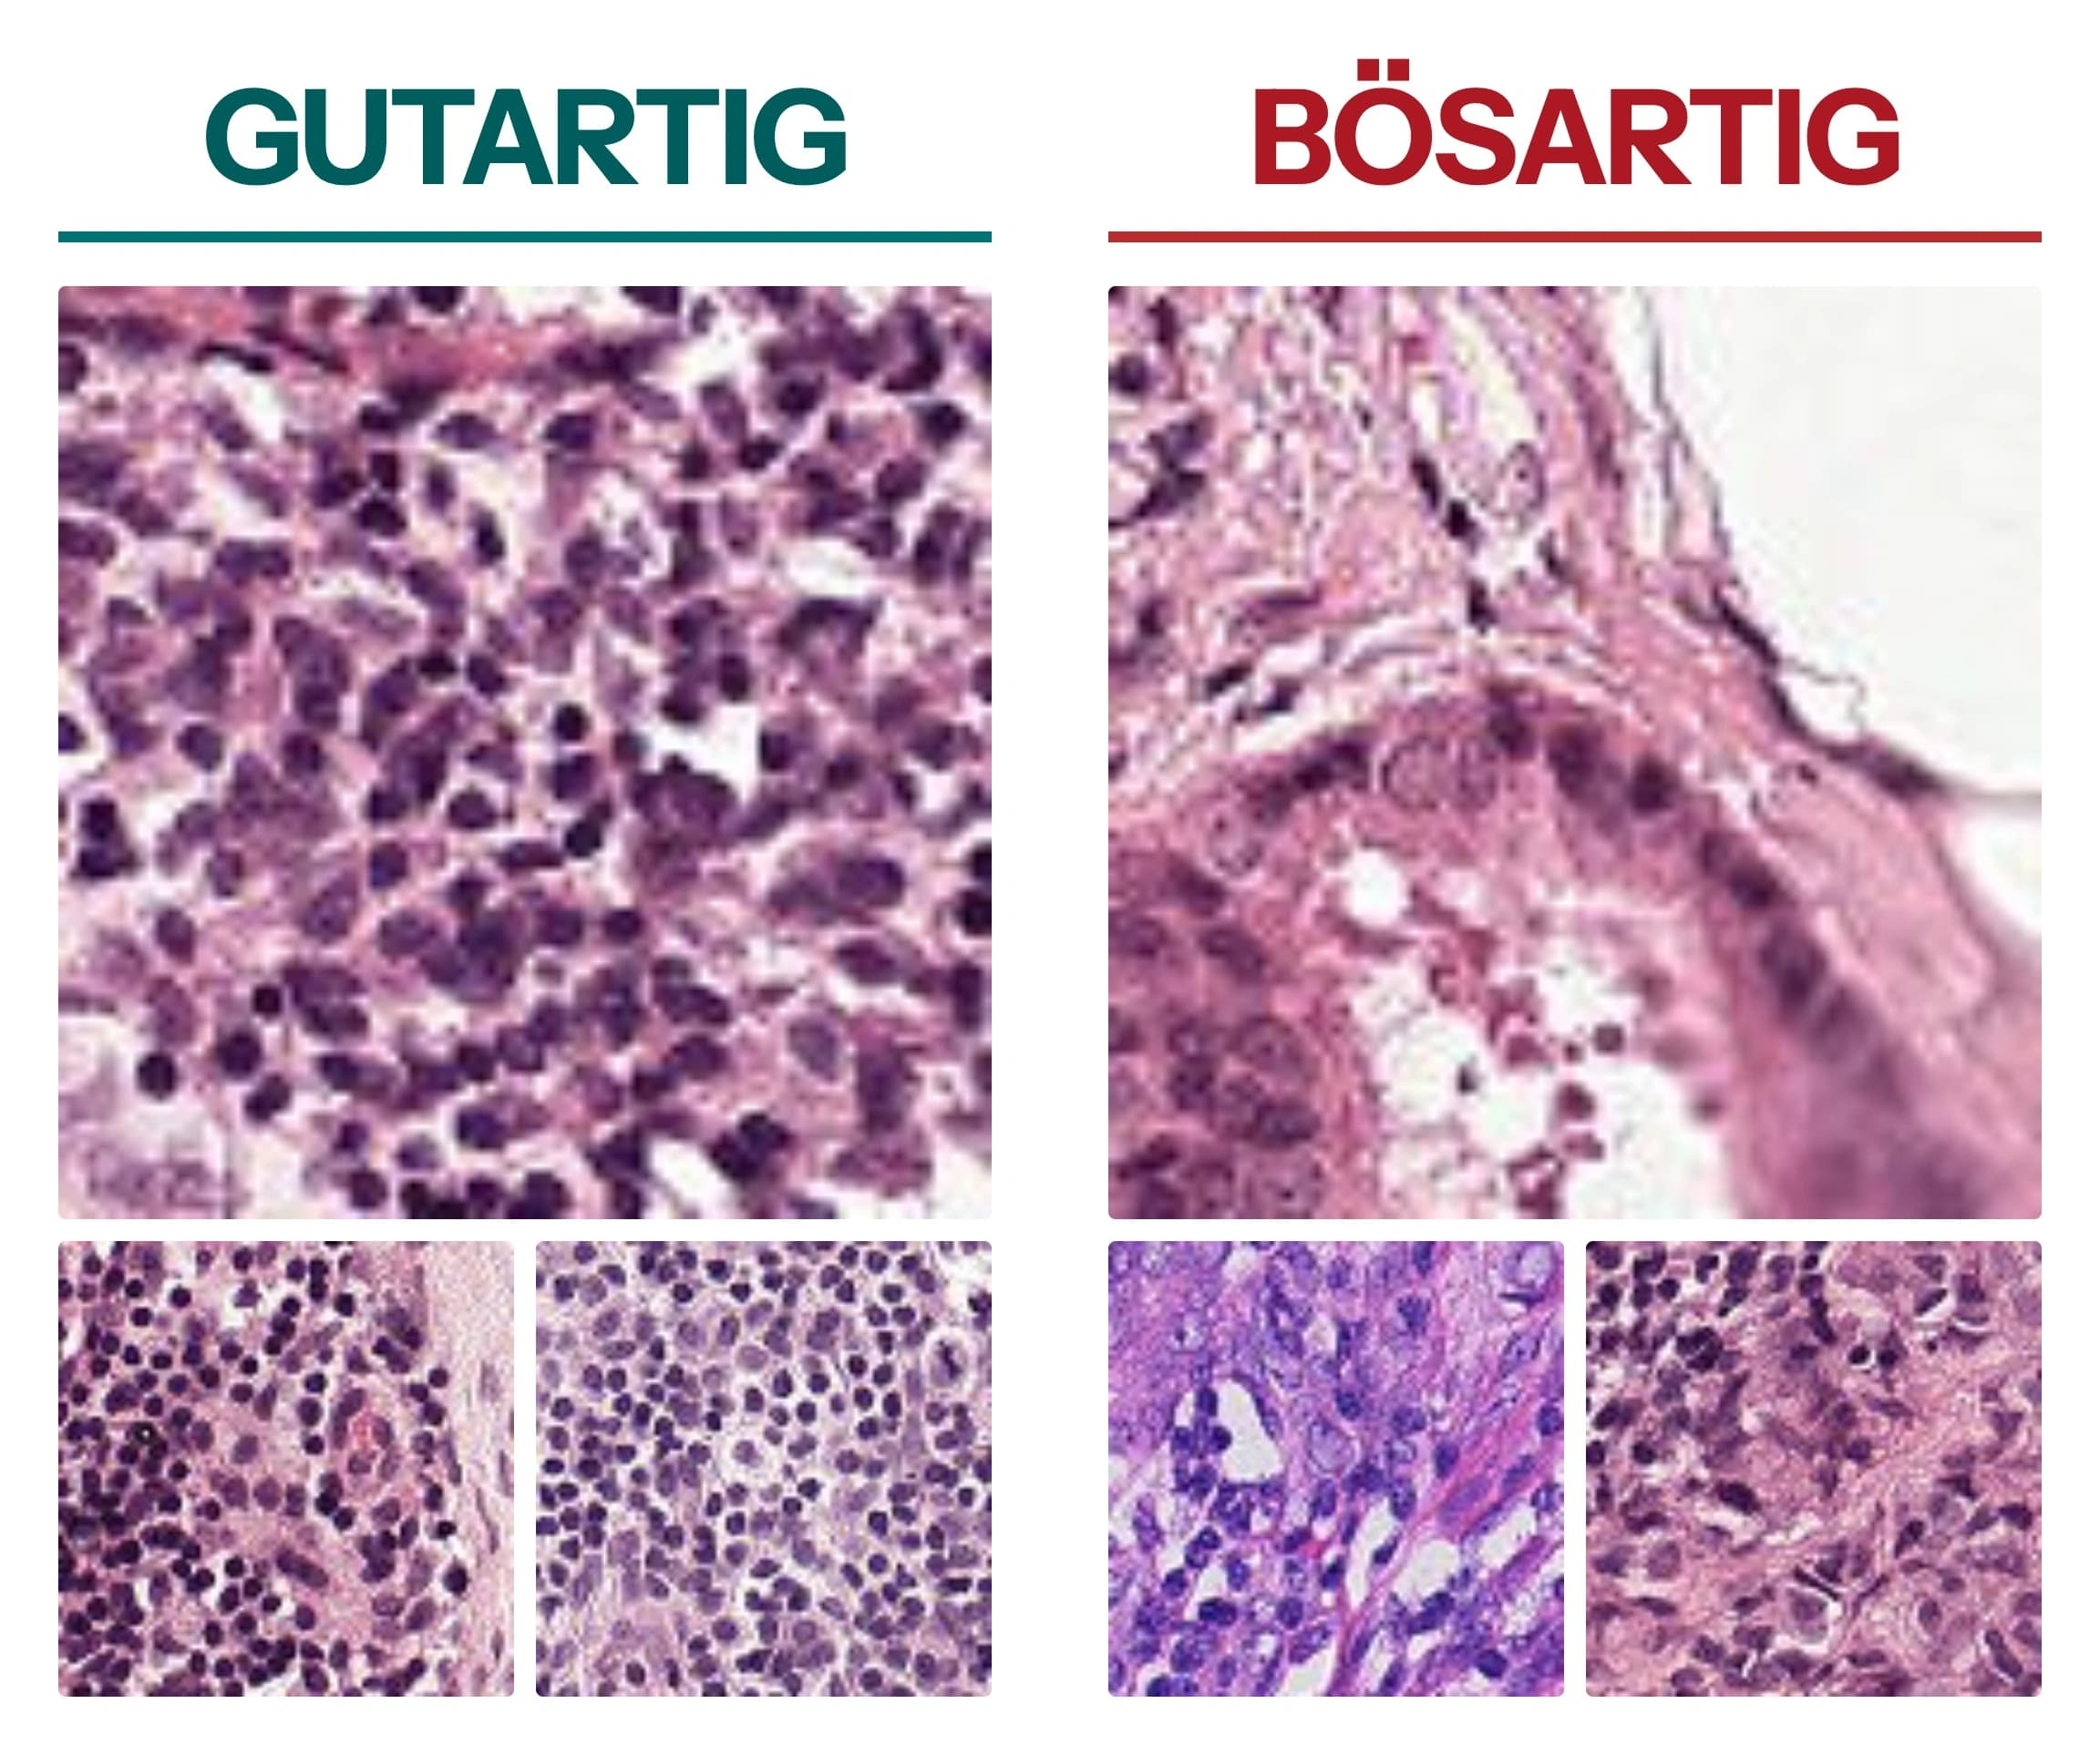
Unterscheidung von bösartigen und gutartigen Gewebeproben: Unter dem Mikroskop erkennt man den Unterschied vor allem an zwei Dingen. Ein gutartiger Lymphknoten besteht fast nur aus kleinen Lymphozyten, deren Zellkerne alle ähnlich groß und ähnlich geformt sind. Metastasen fallen dazwischen als deutlich größere Zellen auf, mit mehr hellem Zytoplasma und Zellkernen, die sich von Zelle zu Zelle unterscheiden. Das zweite Merkmal ist die Anordnung: Lymphozyten verteilen sich gleichmäßig, Tumorzellen lagern sich dagegen zu Nestern oder Strängen zusammen und ziehen oft rosafarbenes Bindegewebe mit sich.
Kontext: Das Projekt ist im Seminar „Deep Learning“ während meines Masterstudiums am Hasso-Plattner-Institut entstanden, gemeinsam mit Eric Fischer, Nicolas Alder, Erik Langenhan, Simon Witzke und Nathaniel Müller.
Zielsetzung: In Deutschland ist die Sterberate bei Krebs seit den 1990er Jahren kontinuierlich gesunken. Gleichzeitig hat sich die Zahl der Neuerkrankungen seit den 70er Jahren vor allem wegen höherer Lebenserwartung fast verdoppelt. 2016 sind in Deutschland 229.900 Menschen neu an Krebs erkrankt. 791.770 Menschen lebten mit einer Krebsdiagnose aus den vorangegangenen fünf Jahren (Bericht zum Krebsgeschehen in Deutschland 2016).
Schon früh streuen Tumore häufig in die umliegenden Lymphknoten. Dort entstehen Metastasen: Zellhaufen, die dem ursprünglichen Tumor (Primärtumor) genetisch und strukturell ähneln, sich aber an anderer Stelle im Körper angesiedelt und einen neuen Tumor gebildet haben. Wie viel davon abhängt, zeigt die 5-Jahres-Überlebensrate: Ohne Lymphknotenmetastasen (Stadium II) liegt sie bei 82,5 %, mit Lymphknotenmetastasen (Stadium III) nur noch bei 59,5 % (O'Connell et al.). Um die Ausbreitung zu beurteilen, wird der Sentinel-Lymphknoten in mehreren Schritten untersucht. Das kostet viel Zeit, obwohl 60–70 % der Sentinel-Lymphknoten gar keine Metastasen enthalten (Litjens et al.).
Der beste Ansatz für die Diagnose vieler Krebsarten ist die mikroskopische Untersuchung von Gewebeproben, die mit Hämatoxylin und Eosin (H&E) gefärbt wurden. Die beiden Farbstoffe färben Zellkerne und umliegendes Gewebe unterschiedlich ein, wodurch Strukturen sichtbar werden. Aus den Gewebeproben lassen sich grob vier Arten von Bildmerkmalen ablesen: Morphometrie (Fläche, Größe, Begrenzung und Form), Topologie (strukturelle Merkmale, z. B. Voronoi-Diagramme), Intensität bzw. Farbe und Textur. Diagnose und Bestimmung des Krankheitsstadiums werden dabei immer aufwändiger: Es gibt mehr Neuerkrankungen und die Behandlungen werden immer individueller. Außerdem müssen Pathologen im klinischen Alltag sehr viele Gewebeproben bewerten. Gleichzeitig lassen sich Gewebeproben heute komplett digitalisieren (Whole Slide Imaging, WSI). Erst durch diese Verfahren gibt es die großen Datensätze, von denen Deep-Learning-Modelle so profitieren.
Besonders "tiefe" Convolutional Neural Networks (CNNs) werden häufig für diese Aufgabe verwendet und erreichen inzwischen ähnliche Genauigkeiten wie medizinische Fachkräfte (Han et al., Coudray et al.). Studien deuten außerdem darauf hin, dass Pathologen, unterstützt von Deep-Learning-Systemen, genauer arbeiten und weniger Zeit pro Bild brauchen (Steiner et al., Kiani et al.). Wie gut ein CNN abschneidet, hängt stark von seiner Architektur ab. Es gibt einige akademische Arbeiten in diesem Feld, allerdings wird meist nur eine Architektur angegeben, die auf ihrem Datensatz am besten funktioniert hat. Wir haben deshalb mehrere CNN-Architekturen auf dem Kaggle PCam-Datensatz verglichen und dabei zudem betrachtet, ob Pretraining und Stain Normalization weitere Qualitätsverbesserungen bedeuten können. Offene Probleme gibt es trotz aller Fortschritte genug: noisy Ground-Truth-Labels, Farbunterschiede zwischen Datensätzen und Proben, unbalancierte Klassen und oft zu wenig gelabelte Daten.
Unser Ziel war es deshalb, herauszufinden, wie gut sich etablierte Deep-Learning-Architekturen dafür eignen, bösartiges Gewebe in Lymphknoten automatisch zu erkennen.
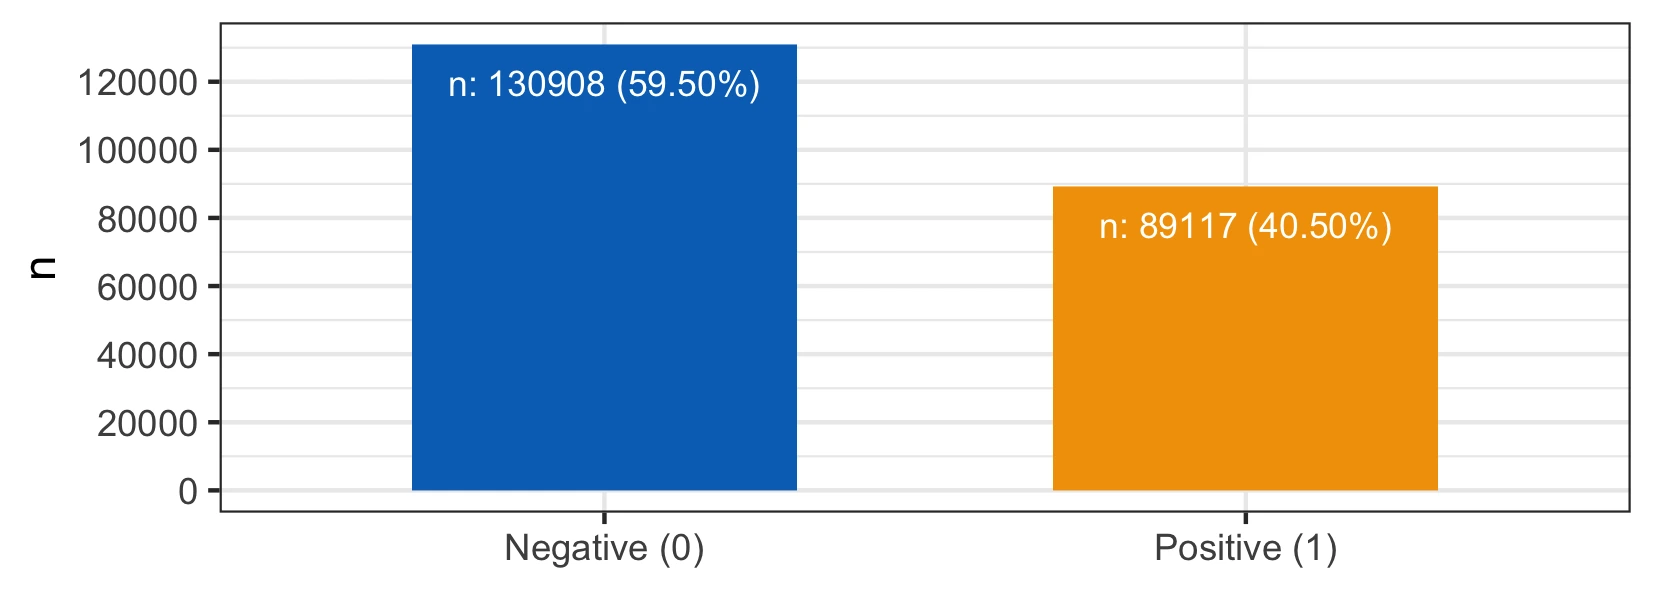
Datensatz: Wir haben eine leicht veränderte Version des PCam-Datensatzes verwendet, die in einer Kaggle-Competition zum Einsatz kam. Sie enthält 220.025 Bilder von Lymphknotenschnitten, jedes 96×96 Pixel groß (27.935 Byte). 130.908 davon zeigen kein Tumorgewebe (Klasse 0), die übrigen 89.117 schon (Klasse 1).
Stain Normalization (Färbenormalisierung): Die Gewebeproben im Datensatz sind mit H&E gefärbt. Die beiden Farbstoffe binden unterschiedlich stark an verschiedene Bestandteile des Gewebes. Unter dem Mikroskop werden die Objektträger dann von unten angeleuchtet. Wie viel Licht welcher Wellenlänge die Färbung dabei schluckt, beschreibt der Stain Vector. Und der schwankt: zwischen verschiedenen Farbstoffen, aber auch bei derselben Färbung, je nach Hersteller, Lagerung und Art und Weise wie das Färbungsmittel aufgetragen wurde.
Proben aus verschiedenen Laboren oder mit unterschiedlicher Vorbereitung weisen meist einen systematischen Bias auf, der mit der Gewebeprobe selbst nichts zu tun hat. Um dieses Problem zu beheben, haben wir die Färbung der Proben normalisiert.
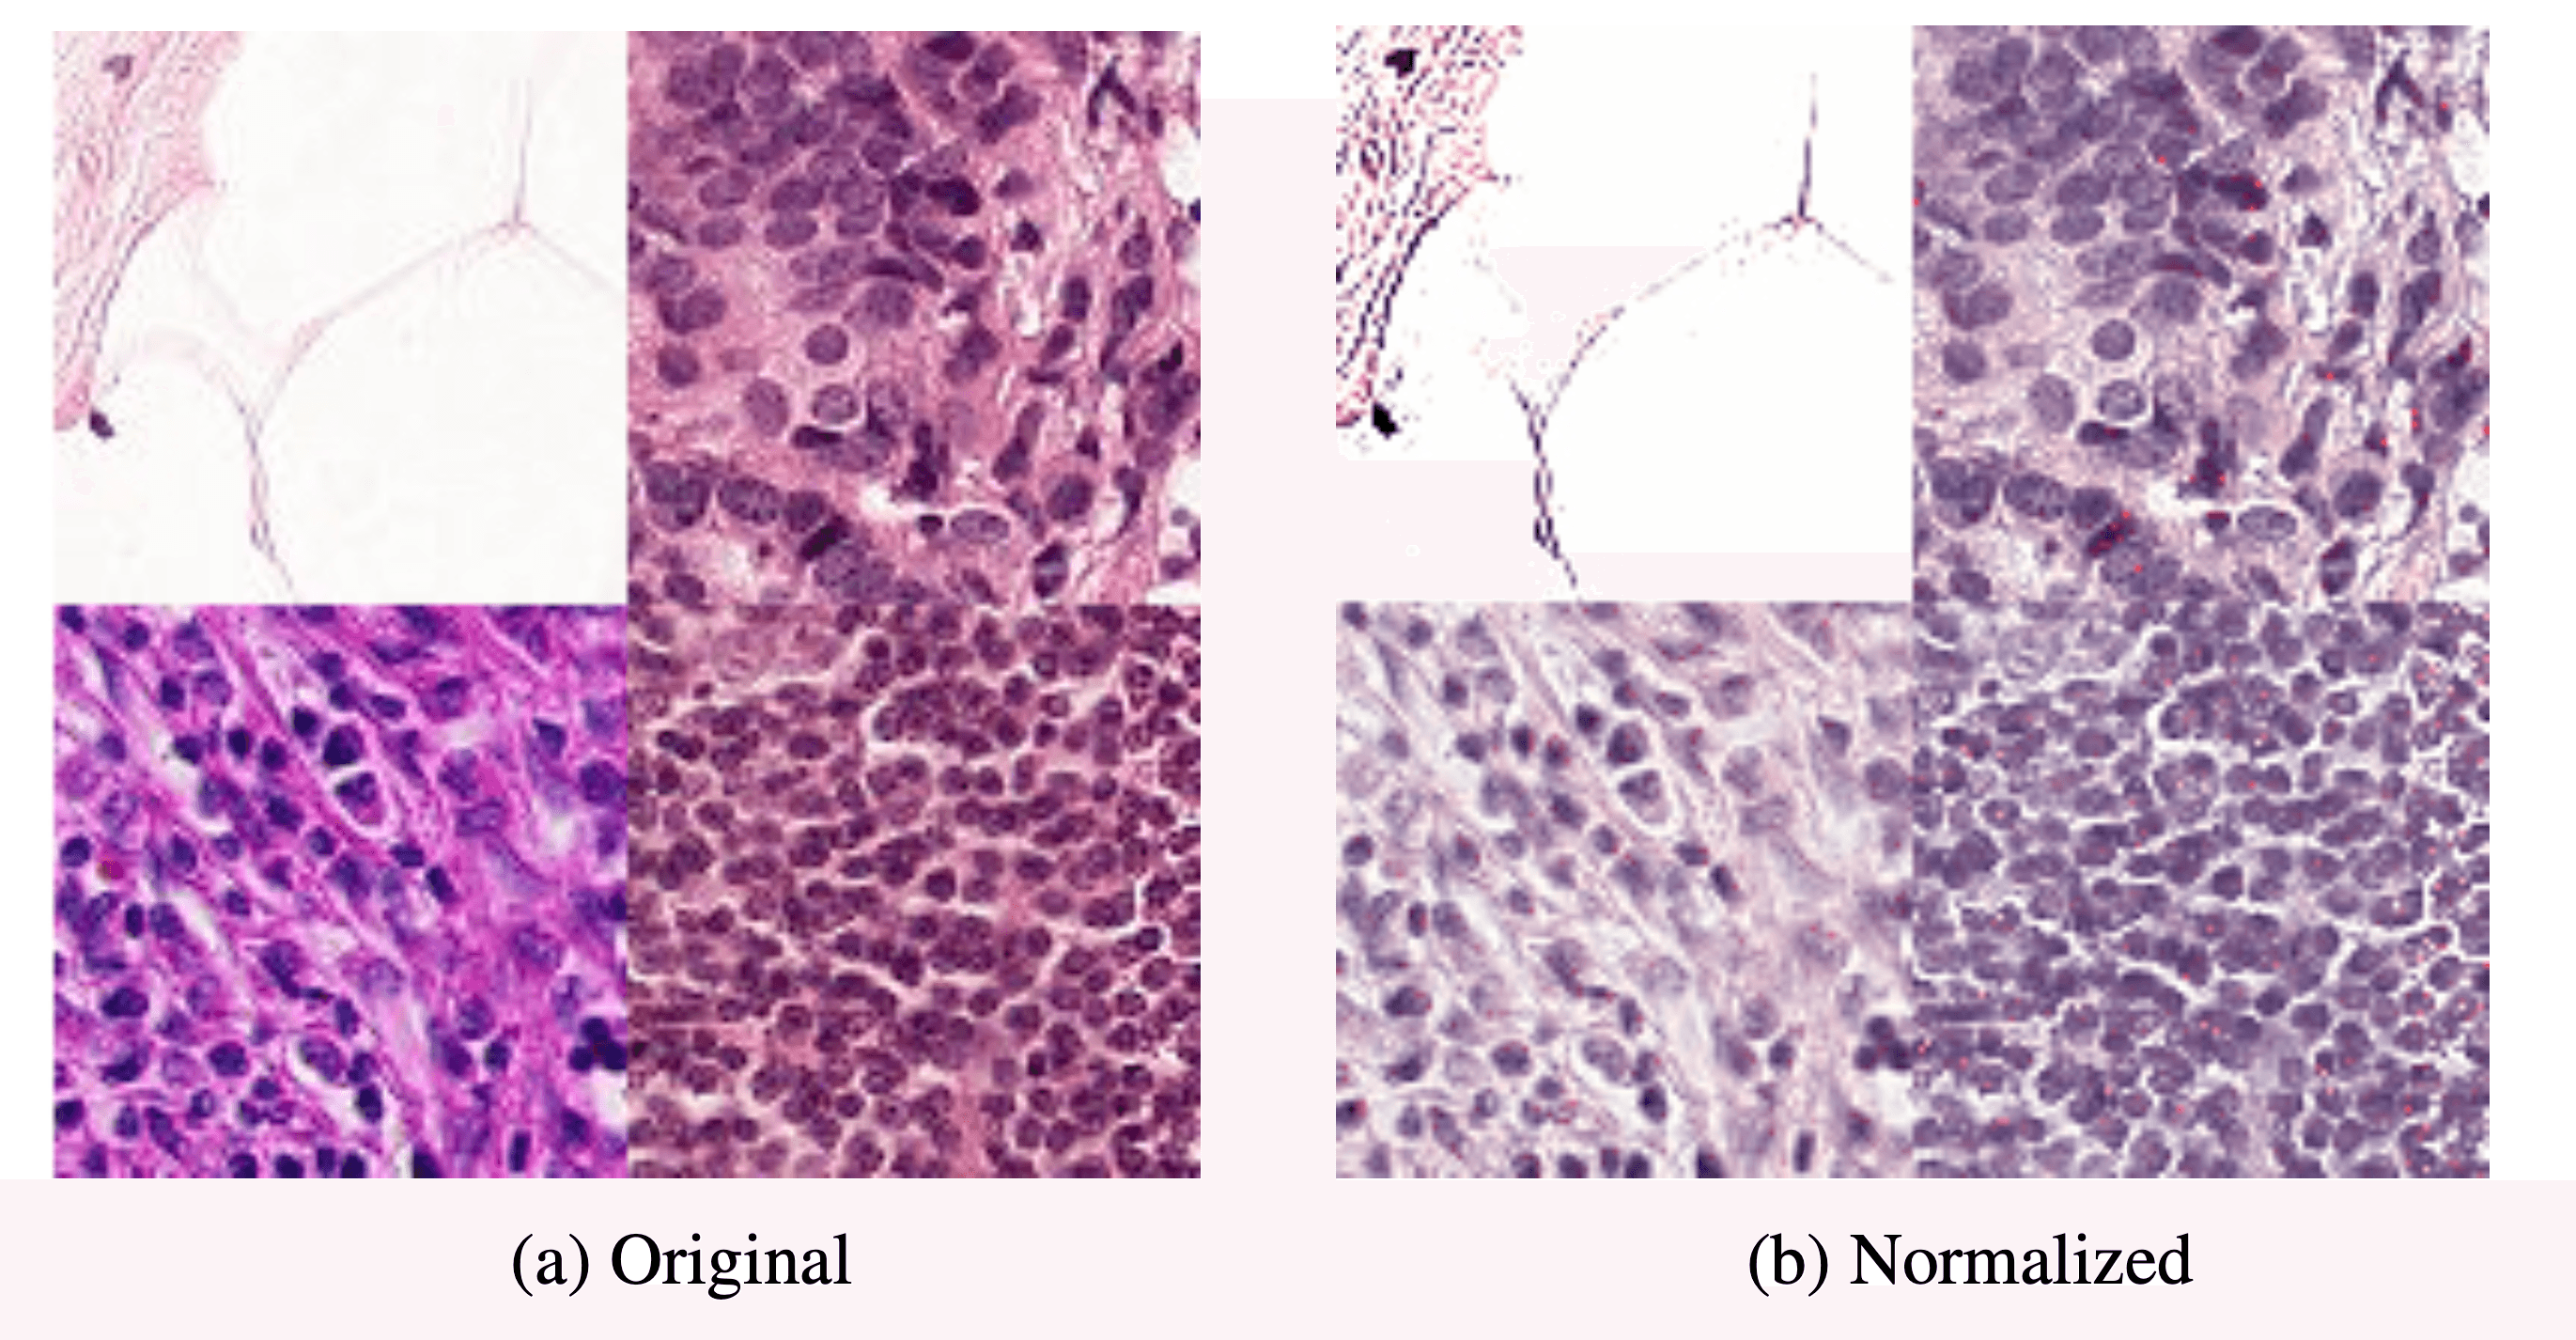
Dafür haben wir das Verfahren von Macenko et al. verwendet. Es bestimmt die Stain Vectors aus den Pixelwerten jedes Bildes mithilfe einer Singular Value Decomposition (SVD). Die Normalisierung des ganzen Datensatzes hat mehrere Stunden gedauert. Deshalb haben wir die Bilder vorab normalisiert, damit das Laden später schneller geht. Dabei werden die Eigenwerte der Stain-Matrizen berechnet. Bei einigen Matrizen ist diese Eigenwertzerlegung nicht konvergiert. Das betraf nur 418 von 220.025 Bildern, die wir deshalb nicht in den normalisierten Datensatz aufgenommen haben.
Das Verfahren macht mehr als nur die Farben anzugleichen. Um die Stain Vectors zu bestimmen, zerlegt das Verfahren jedes Bild in seine zwei Farb-Kanäle. Die zeigen Unterschiedliches: Hämatoxylin färbt die Zellkerne blauviolett, Eosin färbt Zytoplasma und Bindegewebe rosa. Der eine Kanal kodiert also Informationen über den Zellkern, im anderen Informationen über das Gewebe drumherum.
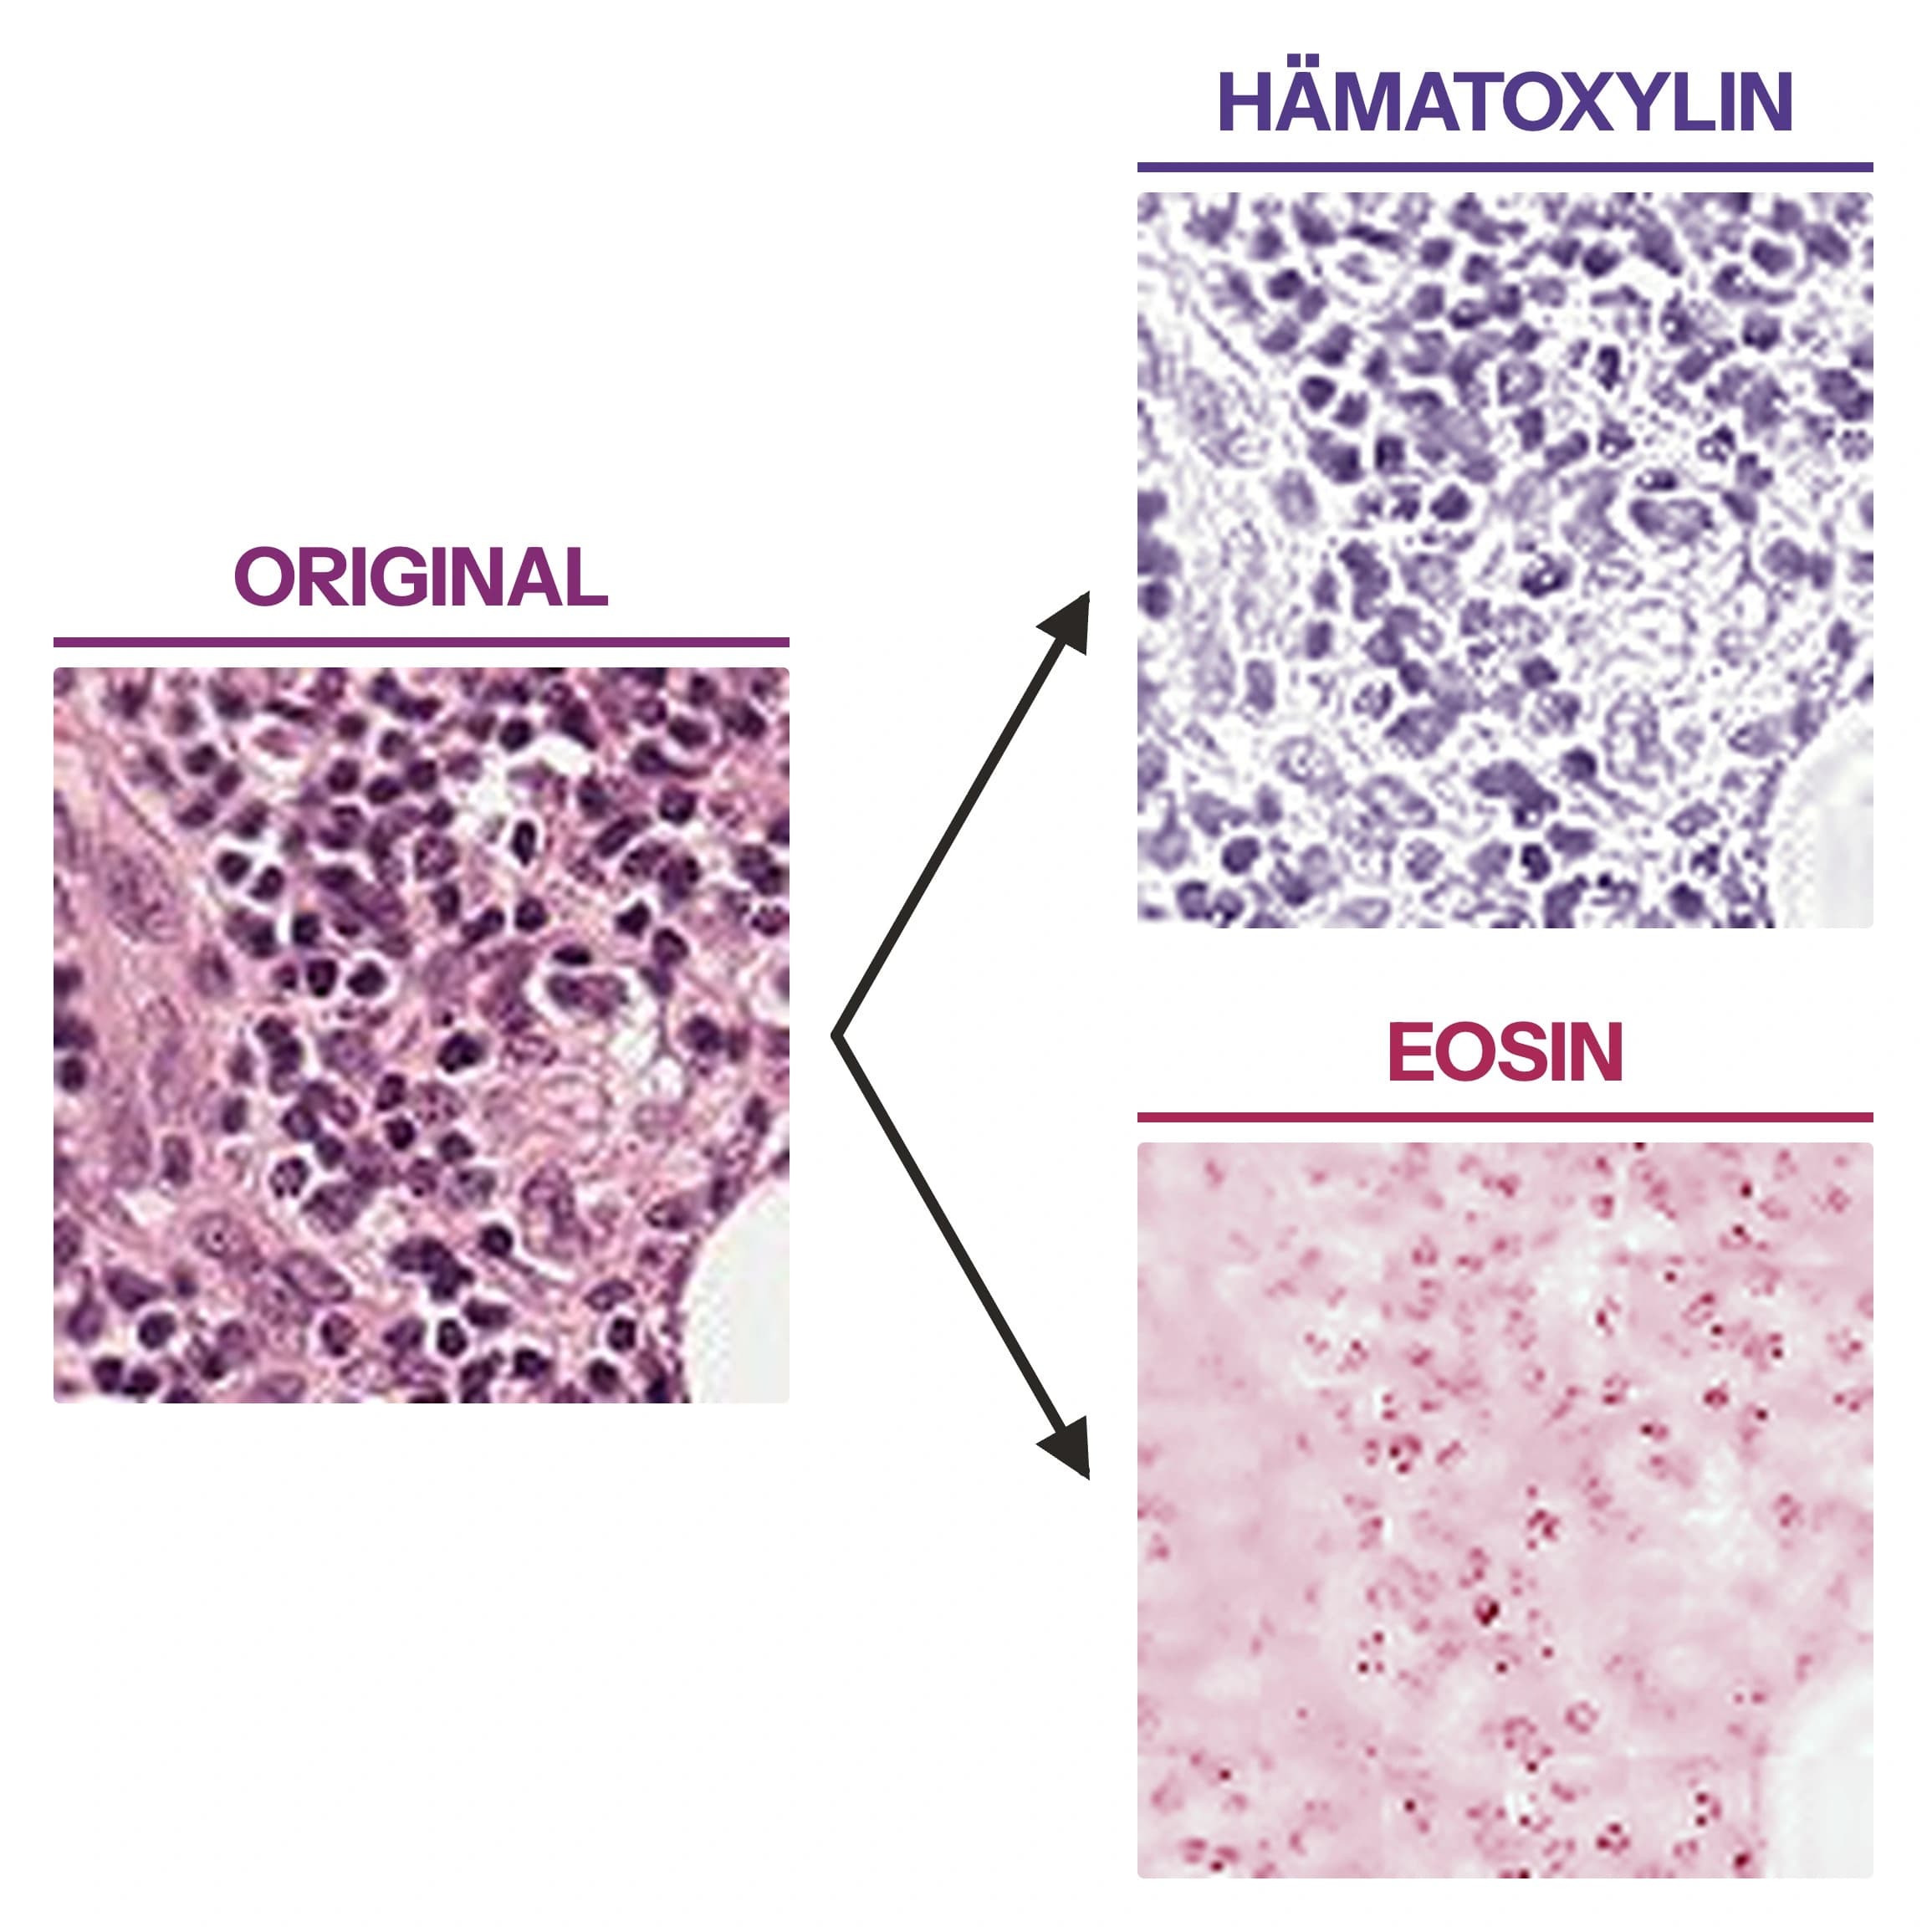
Wir haben die Bilder immer nur im Original oder normalisiert als Input verwendet, nie die beiden Kanäle einzeln. Beide Kanäle getrennt zu verwenden, wäre eine spannede Weiterführung unserer Analyse - so würde das Modell die Form der Zellkerne als eigenes Signal bekommen, also genau das, worauf auch Pathologen achten. Chakraborty et al. haben diesen Ansatz (Stain Decomposition mit einem Dual-Channel Residual Network) auf einem Brustkrebs-Datensatz getestet und vielversprechende Ergebnisse veröffentlicht.
Für die Normalisierung haben wir eine bestehende Python-Implementierung des Macenko-Verfahrens verwendet.
Architekturen: Verglichen haben wir sechs DL-Architekturen: VGGNet11, VGGNet19, ResNet18, ResNet152, DenseNet121 und DenseNet201. Zusätzlich haben wir vortrainierte Varianten verglichen: DenseNet121, DenseNet201, ResNet34 und ResNet101.
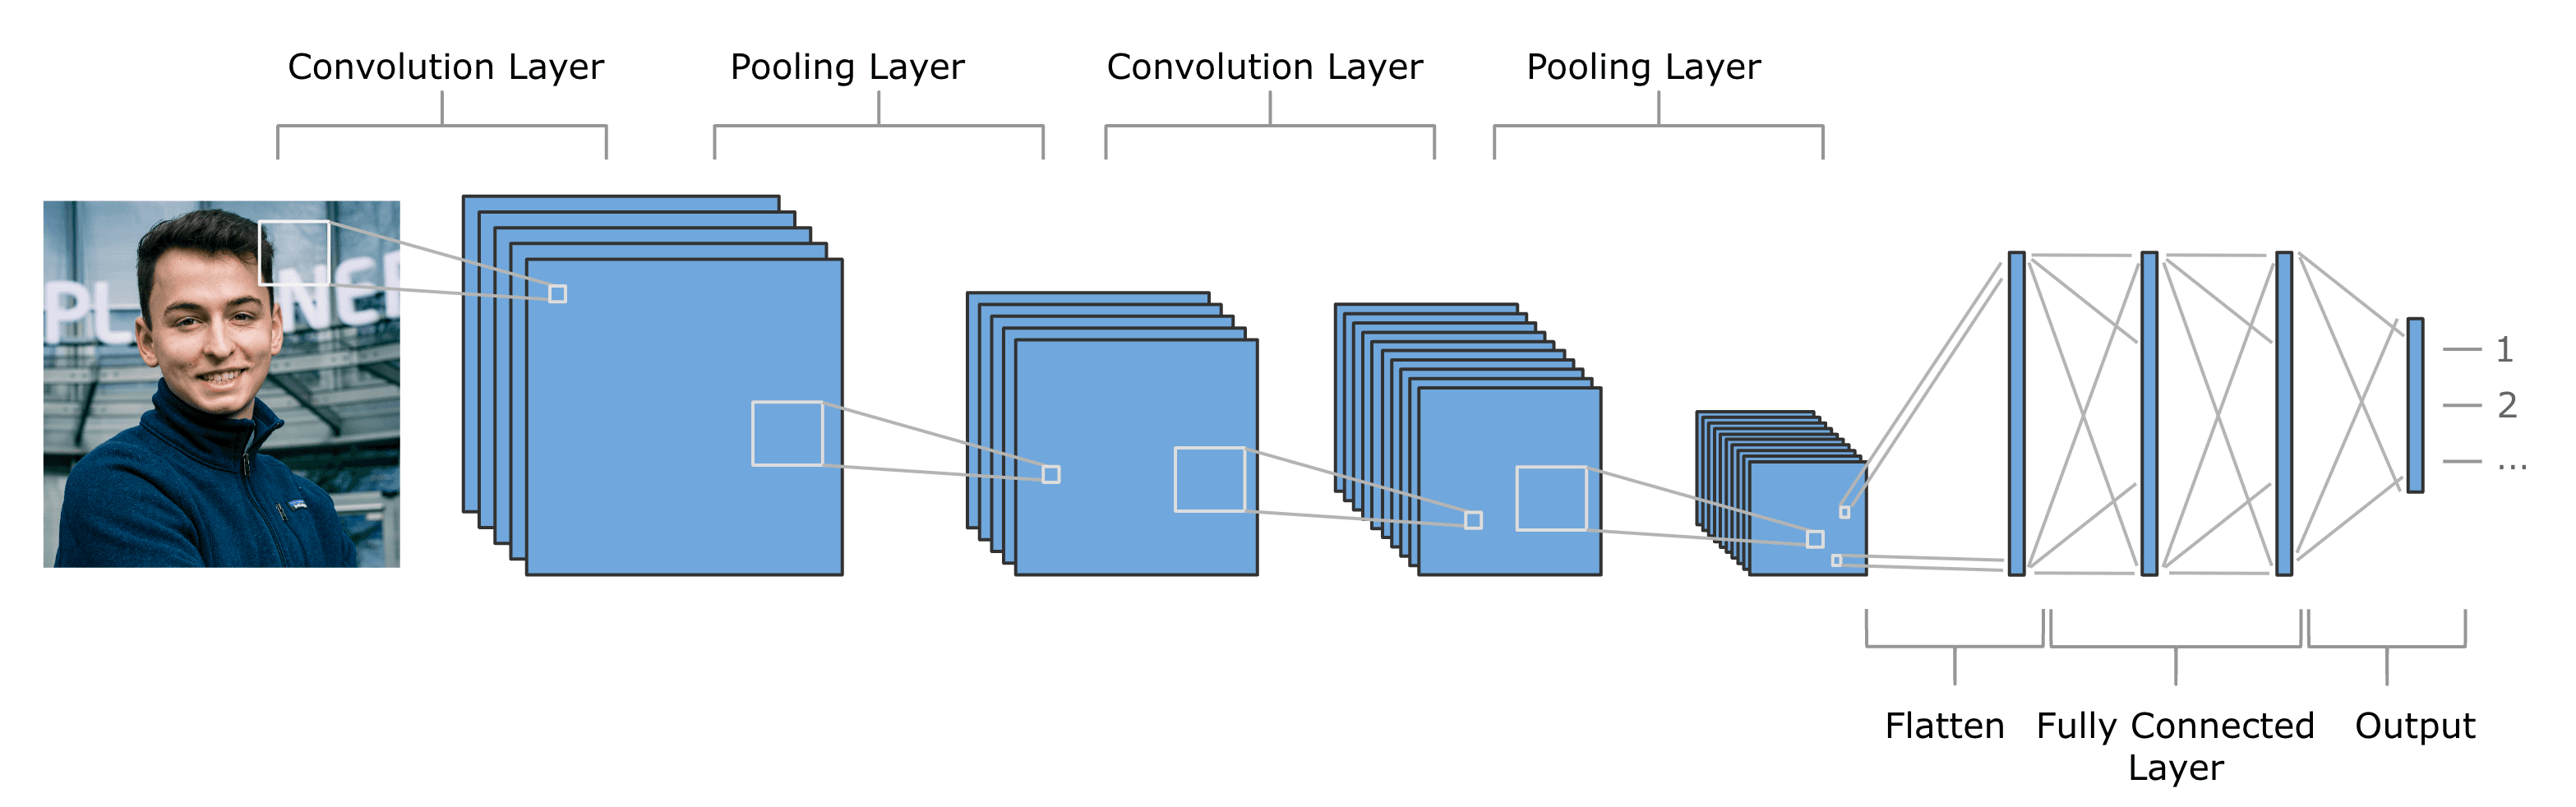
Experiment-Setup: Die Daten haben wir in 176.020 Trainingsbilder (80 %) und 44.005 Testbilder (20 %) aufgeteilt, zusammen rund 6 GB. Auf Cross-Validation haben wir verzichtet: Bei dieser Datenmenge reicht ein einfacher Train-Test-Split. Mit k-Fold-Cross-Validation hätte sich die Trainingszeit vervielfacht. Als Modelle haben wir PyTorch-Architekturen verwendet und über skorch trainiert. Den Classification Layer haben wir so angepasst, dass er nur noch einen einzelnen Output liefert. Insgesamt haben wir 150 Experiment-Runs mit je 30 Epochen trainiert, mit Binary Cross Entropy (with Logits) als Loss, Adam Optimizer, einer Batch Size von 128 und einer Learning Rate von 0,01. Nur die VGGNets haben mit einer Learning Rate von 0,001 und Adamax brauchbare Ergebnisse geliefert. Trainiert haben wir auf Google Colab (Nvidia Tesla K80) und auf einem Server des Lehrstuhls mit vier Nvidia Tesla V100, den wir im Rahmen des Projekts nutzen durften.
Experiment-Dokumentation: Jeden Run haben wir in einem Neptune.ai-Projekt gelogged. Das hat die Analyse und Optimierung deutlich vereinfact. Außerdem konnten wir die MOdelle später für Predictions wieder laden. Der Code für unser Projekt liegt in GitHub.
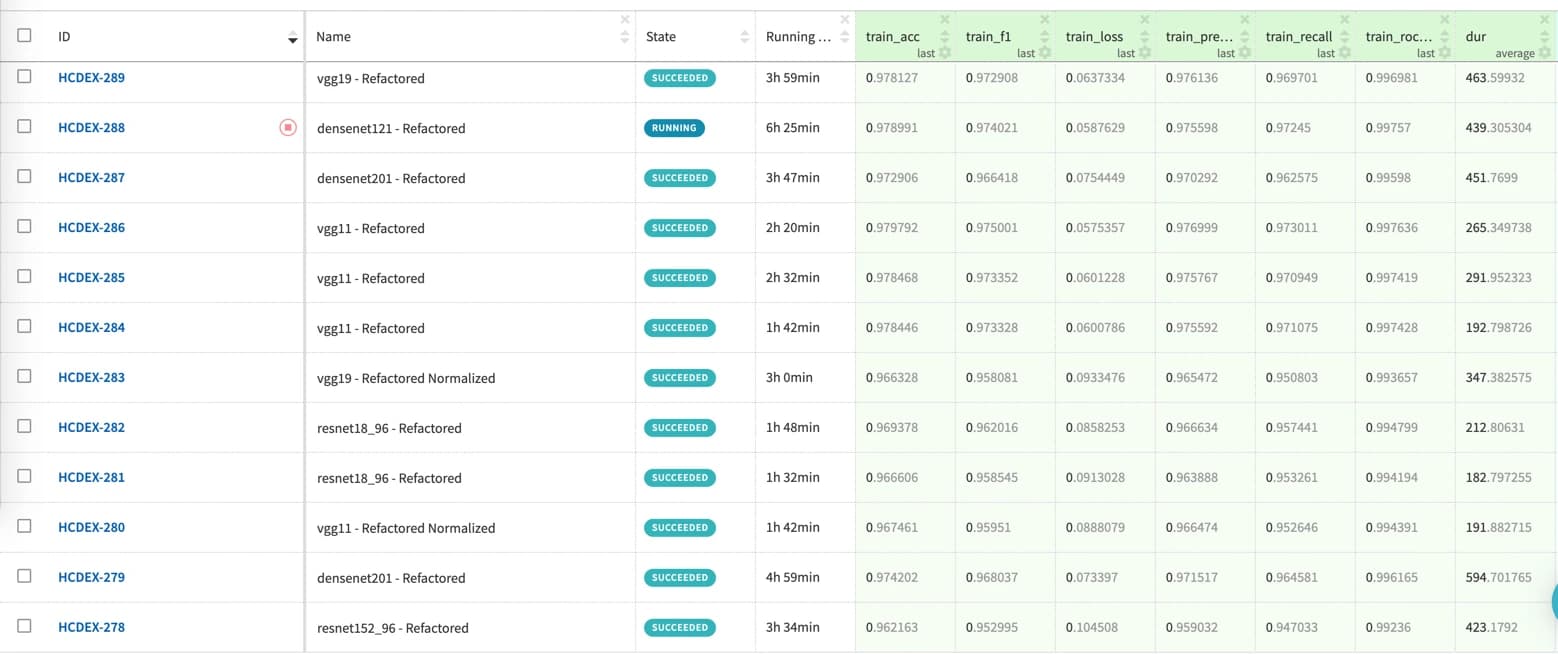
Alle Runs mit ihren Metriken in Neptune.ai.
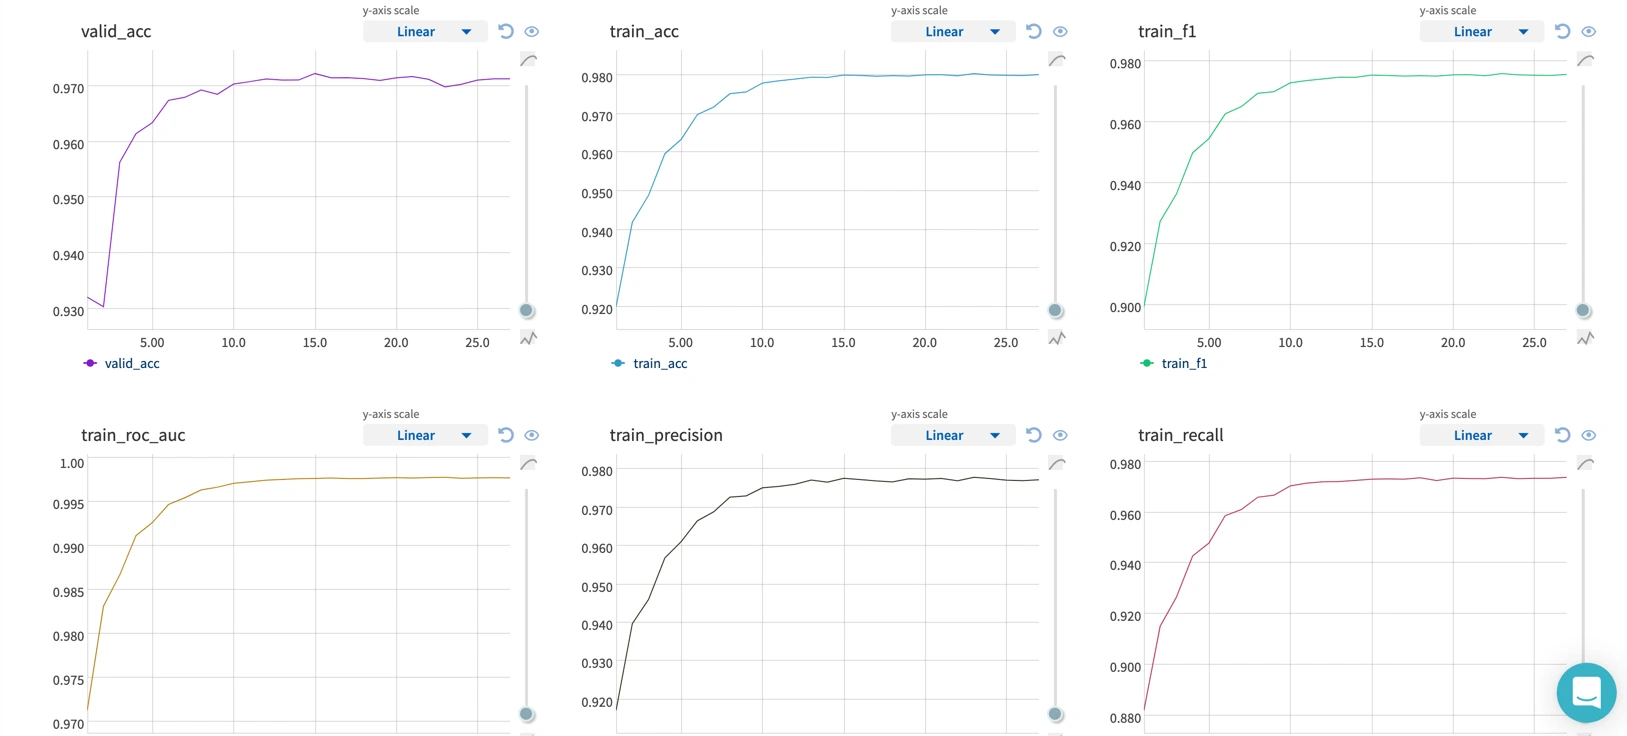
Die Kurven eines einzelnen Runs. In den ersten 5 Epochen sieht man die meiste Veränderung.
Ergebnisse: Auf dem vollen, nicht normalisierten Datensatz hat ein DenseNet201 ohne Pretraining die beste Accuracy (97,65 %) und den besten F1-Score (97,09 %) erreicht. Den besten Recall (97,57 %) hatte ein zweiter DenseNet201-Run, die beste AUROC (99,53 %) ein vortrainiertes ResNet34.
| Metrik | DenseNet201 | DenseNet121 | DenseNet201 (zweiter Run) | ResNet34 (vortrainiert) |
|---|---|---|---|---|
| Test-Accuracy | 97,65 | 97,47 | 97,19 | 97,11 |
| Test-F1 | 97,09 | 96,85 | 96,57 | 96,43 |
| Test-Precision | 97,28 | 97,47 | 95,58 | 96,45 |
| Test-Recall | 96,91 | 96,24 | 97,57 | 96,41 |
| Test-AUROC | 97,54 | 97,27 | 97,25 | 99,53 |
Was uns überrascht hat. Tiefere Modelle haben kaum etwas gebracht: VGGNet19 war kaum besser als VGGNet11, ebenso ResNet152 gegenüber ResNet18 und DenseNet201 gegenüber DenseNet121. Pretraining hatte keinen nennenswerten Effekt: Bei den ResNets war es rund 1 % besser, bei den DenseNets rund 1–2 % schlechter. Und entgegen unserer Erwartung hat die Normalisierung die Ergebnisse bei fast allen Modellen verschlechtert. Warum, lässt sich bei einem Black-Box-Modell schwer sagen. Möglicherweise nutzen die Modelle Farbe und Kontrast stärker als gedacht, sodass die Normalisierung nicht nur Rauschen, sondern auch nützliche Information entfernt hat.
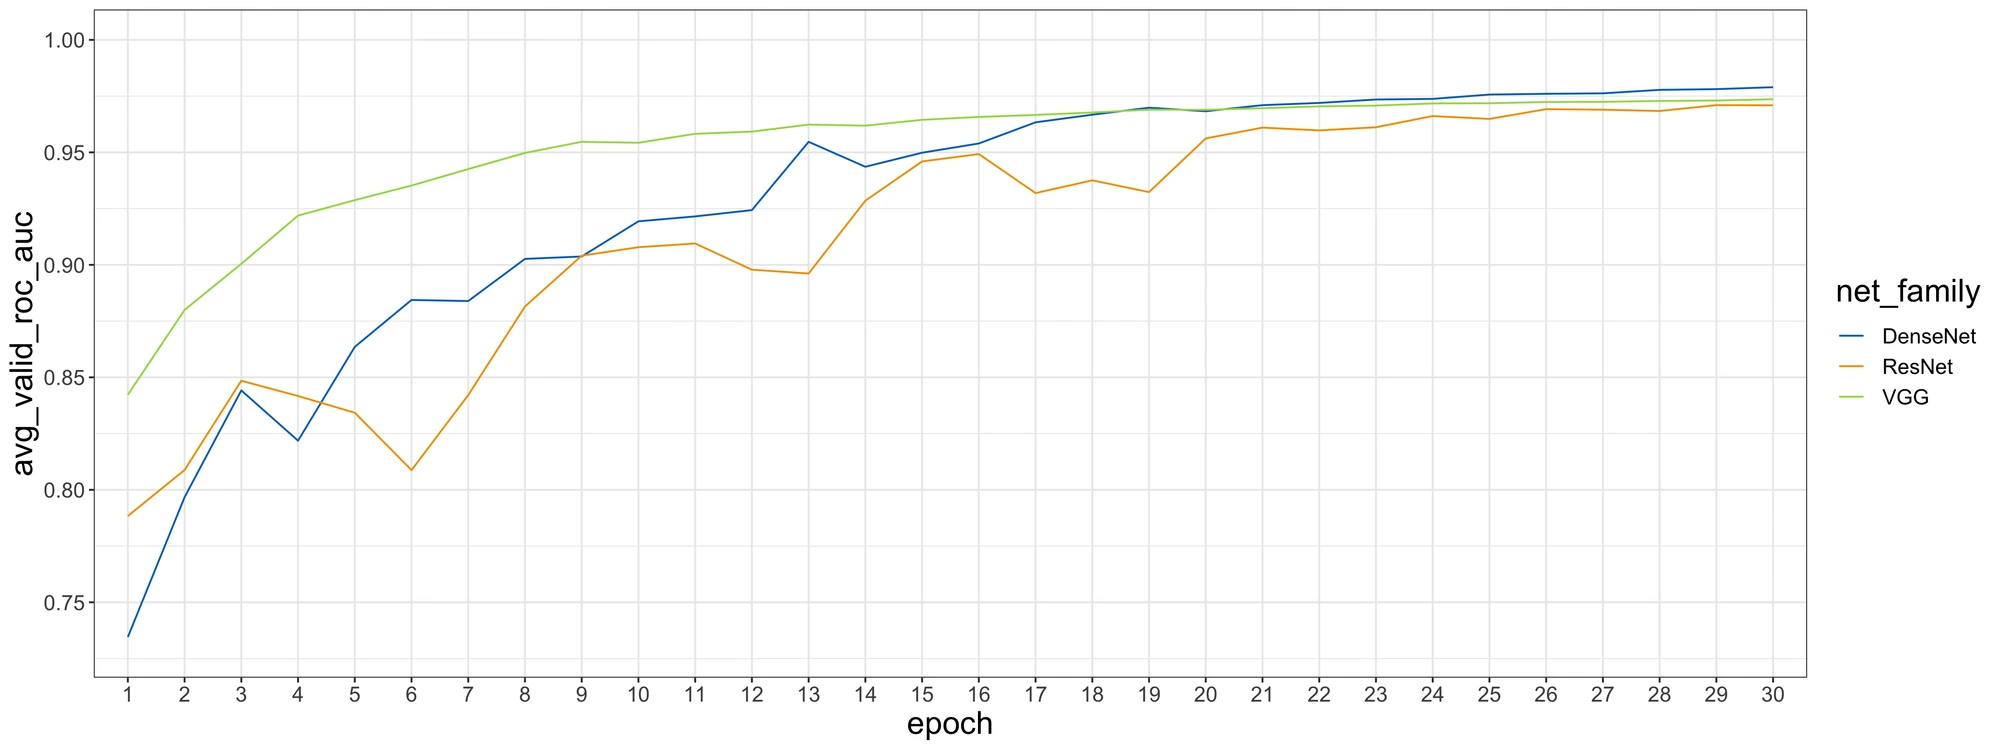
Gemittelt über alle Runs einer Familie. VGG lernt am schnellsten, nach rund 20 Epochen liegen alle drei aber gleichauf.
Fazit: Bei einem Datensatz dieser Größe kann man VGGNets, ResNets und DenseNets gleichermaßen einsetzen, bei einem kleinen würden wir eher ein DenseNet201 empfehlen. Wichtiger als die Architektur ist aber die Wahl der Metrik. Ein False Negative ist eine übersehene Metastase. Ein False Positive bedeutet eine unnötige Nachuntersuchung, die Kosten verursacht und Betroffene psychisch belastet, aber niemanden das Leben kostet. Die beiden Fehler wiegen also nicht gleich schwer. Deshalb sollte der Recall mehr Gewicht bekommen als die Accuracy, die True Positives und True Negatives gleich behandelt.
Paper: Rückblickend hat es wirklich Spaß gemacht, an diesem Research-Projekt zu arbeiten. Unser Paper, das wir als Abschlussarbeit des Seminars geschrieben haben, gibt es hier: Deep Learning for Histopathologic Cancer Detection (PDF).