Erstellung eines Knowledge Graphen aus kunsthistorischen Dokumenten
Abstrakt: Gemeinsam mit dem Wildenstein Plattner Institute in New York haben wir im Rahmen eines Universitätsprojekts am Hasso-Plattner-Institut einen Knowledge Graphen aus kunsthistorischen Dokumenten erstellt. Ziel war es, die Beziehungen zwischen Kunstwerken, KünstlerInnen und historischen Ereignissen als Graph abzubilden und diese Darstellung für weitere Analysen nutzbar zu machen.
Kontext: Das im Folgenden beschriebene Projekt wurde im Rahmen einer Lehrveranstaltung mit dem Titel „Knowledge Graphs“ im Rahmen meines Masterstudiums am HPI durchgeführt – gemeinsam mit Konstantin Dobler und Malte Barth. Das Seminar gliederte sich in zwei Teile: Zunächst standen zentrale Konzepte und die Auseinandersetzung mit der aktuellen wissenschaftlichen Literatur auf dem Programm, anschließend ein praktisches Projekt in Zusammenarbeit mit dem Wildenstein Plattner Institut in New York – einer gemeinnützigen Stiftung, die sich der Erforschung der Kunstgeschichte widmet und unter anderem die Digitalisierung kunsthistorischer Artefakte und Dokumente treibt.
Was ist ein Knowledge Graph? Ein Knowledge Graph dient dazu, Wissen strukturiert zu speichern und darzustellen. Knoten und Kanten werden verwendet, um Entitäten und deren Beziehungen abzubilden. Entitäten können dabei Personen, Orte, Objekte oder Konzepte sein. Die Beziehungen zwischen Entitäten werden durch Kanten mit optionalen Eigenschaften dargestellt. Im Kern repräsentiert ein Knowledge Graph Fakten als Tripel bestehend aus Subjekt (Entität), Prädikat (Relation) und Objekt (Entität).
Ein Beispiel hierfür wäre (Barack Obama – geboren in – Honolulu). Diese Darstellung ist flexibler und ausdrucksstärker als eine klassische relationale Datenbank und eröffnet Möglichkeiten für weitergehende Analysen und Machine Learning. Häufige Anwendungsfälle sind unter anderem1:
- Verbesserung von Suche durch die Verknüpfung verschiedener Informationen.
- Empfehlungssysteme, da Knowledge Graphen über das Verständnis der Beziehungen zwischen Entitäten personalisierte Empfehlungen ermöglichen.
- Semantic Web: Knowledge Graphen können Informationen aus verschiedenen Quellen verknüpfen und so die Websuche und Informationsdarstellung verbessern.
- Weitere NLP-Aufgaben: Knowledge Graphen können verwendet werden, um die Bedeutung von Texten zu erfassen und die Genauigkeit natürlichsprachlicher Aufgaben wie maschinelle Übersetzung und Question Answering zu verbessern.
Wichtige Anmerkung: Knowledge Graphen sind ein spannender Ansatz, aber für die genannten Anwendungsfälle gibt es auch andere Ansätze, die semantische Informationen in Texten nutzen. Weit verbreitet sind Knowledge Graphen trotzdem. Im Enterprise-Bereich verfügen beispielsweise Google und Microsoft über Graphen mit mehreren Milliarden Fakten, die aktiv in ihren Produkten eingesetzt werden (Stand: 2019)2.
Was ist eine Ontologie? Eine Ontologie beschreibt formal, welche Konzepte es in einem Wissensbereich gibt und wie sie zusammenhängen. Sie legt fest, welche Typen von Entitäten existieren, welche Eigenschaften diese haben und wie sie zueinander in Beziehung stehen. Üblicherweise liegt eine Ontologie in einem maschinenlesbaren Format vor – RDF (Resource Description Framework) oder OWL (Web Ontology Language). Damit lassen sich Klassen und Eigenschaften standardisiert definieren und Einschränkungen für deren Beziehungen ausdrücken.
Je nach Anwendungszweck umfasst die Arbeit mit Knowledge Graphen mehrere Schritte. Das Framework in der folgenden Abbildung gibt einen sehr guten Überblick über die einzelnen Schritte3.
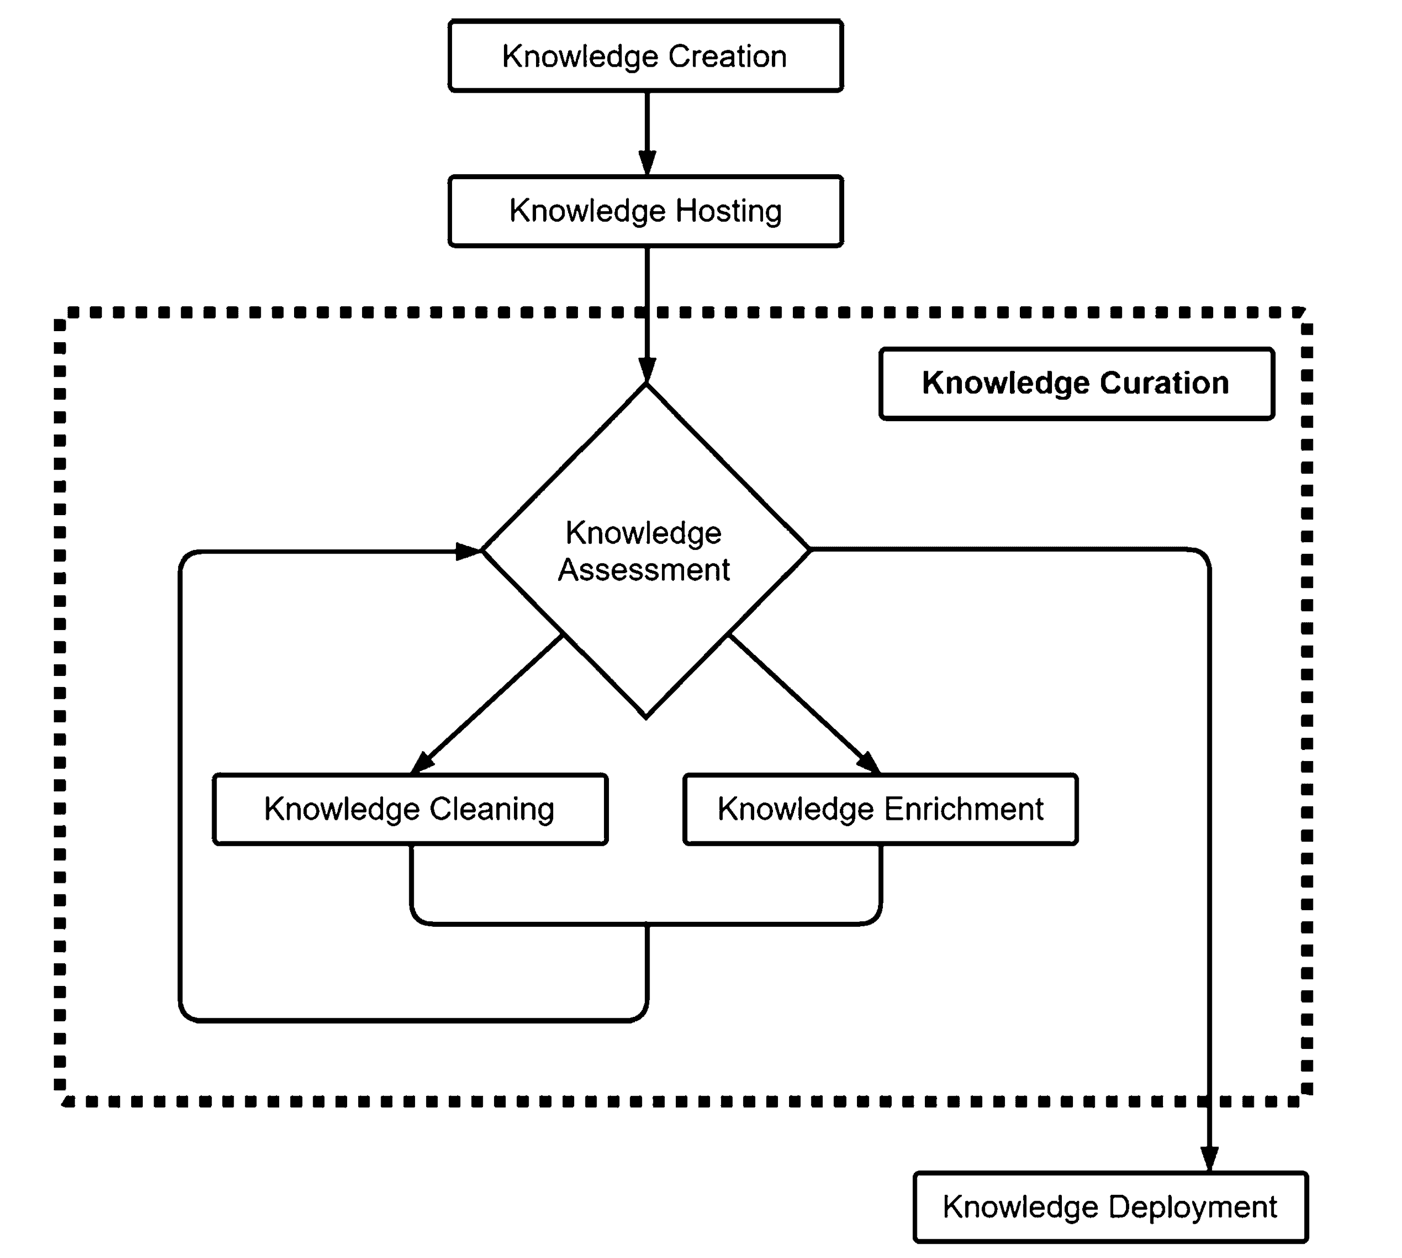
Unser Projekt: Open Knowledge Graph Creation für kunsthistorische Dokumente mit dem Wildenstein Plattner Institute New York
Im Rahmen des Seminars arbeiteten wir mit einem umfangreichen Korpus kunsthistorischer Dokumente, aus denen wir einen Knowledge Graph für weiterführende Anwendungsfälle erstellten. Unser Schwerpunkt lag dabei auf der Konstruktion des Knowledge Graphen - nicht die nachgelagerten Anwendungsfälle.
Die von uns verwendeten Daten waren bereits gescannte und vorverarbeitete kunsthistorische Dokumente, die mittels OCR (Optical Character Recognition) gescannt wurden. Der Datensatz umfasste rund eine Million Sätze, gespeichert in mehreren .txt-Dateien.
Zu Beginn haben wir Verfahren wie Named Entity Recognition (siehe Abbildung unter Verwendung von Spacy – einem Python-basierten NLP-Framework) eingesetzt, um ein erstes Verständnis für den Datensatz zu gewinnen. Dieser Ansatz ist an eine vordefinierte Ontologie gebunden. In einem idealen Szenario findet man erst eine passende Ontologie für die aktuelle Domäne und entwickelt ein Verständnis dafür, wie sich Entitäten und Relationen dieser Ontologie zuordnen lassen.
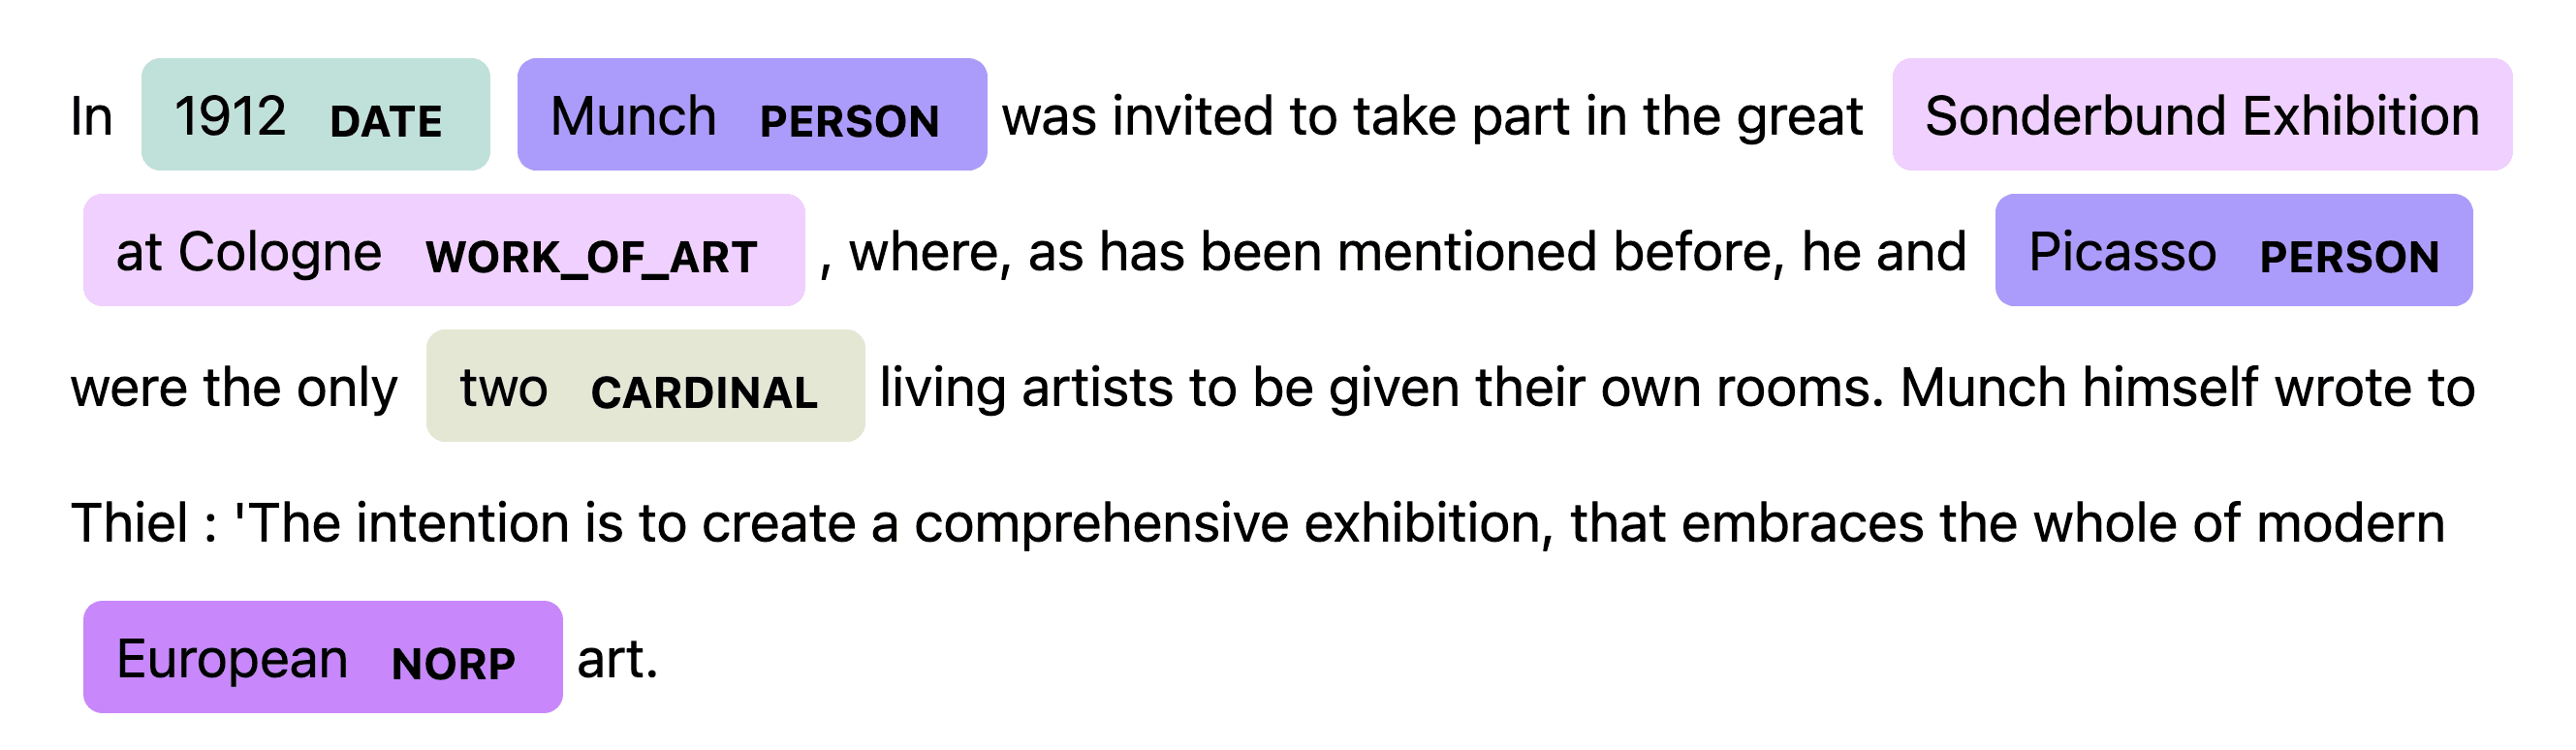
Für einen ersten Blick in die Daten ist das ein guter Ansatz – dennoch ist unklar, was passieren soll, wenn z. B. etwas hinzukommt, das bisher außerhalb der Ontologie liegt (Out of Ontology). Deshalb haben wir einen Green-Field-Ansatz ohne vordefinierte Ontologie verfolgt. Das Projekt konzentrierte sich hauptsächlich auf die Erstellung eines Knowledge Graphen mit den vorliegenden Daten und die anschließende Bewertung der Qualität des gespeicherten Wissens. Drei Hauptschritte:
- Open Information Extraction (OpenIE): Extraktion von Tripeln (Subjekt – Prädikat – Objekt) aus Texten.
- Knowledge Graph Embeddings: Repräsentation von Wissen in einer vielseitig einsetzbaren Form für nachgelagerte Anwendungen wie maschinelles Lernen.
- Canonicalization (Kanonisierung) durch Clustering von Relationen und Entitäten: Zusammenführung mehrerer Entitäten und Relationen in ein Standardformat. Die Ergebnisse von OpenIE sind nicht kanonisiert – wir speichern also redundante und mehrdeutige Informationen.
Details zur Open Information Extraction: Dafür haben wir das bestehende OpenIE6-System genutzt, das iteratives Grid Labelling und Koordinationsanalyse einsetzt4. Als Schritt davor wurde Co-Reference Resolution durchgeführt, bei der Nennungen im Text, die sich auf dieselbe Entität beziehen, geclustert und ersetzt werden. Ein Beispiel: Zwei Sätze wie „Christian hat viel über Knowledge Graphen gelernt. Er liest nun häufig Blogs darüber.“ würden zu „Christian hat viel über Knowledge Graphen gelernt. >Christian< liest nun häufig Blogs über >Knowledge Graphen<.“ geändert. OpenIE macht aus einzelnen Sätzen Tripel (Subjekt – Prädikat – Objekt), mit denen wir weiterarbeiten. Wir haben Filterheuristiken eingesetzt, sodass irrelevante Tripel wie beispielsweise „One – can skip – truth“ herausgefiltert werden. Ungefiltert waren das rund 3 Millionen Tripel – nach der Vorverarbeitung blieben etwa 500.000 übrig.
Details zu Knowledge Graph Embeddings: Embeddings für Entitäten und Relationen zu lernen, ist eine vielseitige Art, dieses Wissen zu repräsentieren – und darauf Machine Learning oder andere Aufgaben anzuschließen. Hierfür haben wir mehrere bekannte Verfahren ausprobiert: TransE, HolE, ConvE und CESI, mit dem sich Knowledge Graphen über Embeddings und zusätzliche Side Information kanonisieren lassen.
Details zur Canonicalization: Ziel ist, mehrere Schreibweisen derselben Entität oder Relation auf eine Form zu bringen. Ein Beispiel: Mein Name könnte im Knowledge Graph als „Christian Warmuth“, „C. Warmuth“ oder „Christian W.“ auftauchen. Über Embeddings landet diese Information in einem hochdimensionalen Raum. Clustern wir diesen und ersetzen alle Entitäten eines Clusters durch einen repräsentativen Eintrag, bleibt im Beispiel eine Schreibweise übrig – etwa „C. Warmuth“. CESI nutzt dafür Hierarchical Agglomerative Clustering (HAC), das mit einer quadratischen Laufzeit von O(n^2) bei unseren rund 500.000 Tripeln nicht praktikabel ist. Wir sind deshalb auf DBSCAN ausgewichen, einen dichtebasierten Algorithmus, der ohne vorgegebene Anzahl von Clustern auskommt.
Ergebnis der Canonicalization:
| Input | ~ 500k Nominalphrasen |
| ~ 62k Relationsphrasen | |
| ~ 370k eindeutige Tripel | |
| Output | ~ 350k Nominalphrasen (Diff: ~150k, -30%) |
| ~ 13k Relationsphrasen (Diff: ~45k, -79%) | |
| ~ 345k eindeutige Tripel (Diff: ~25k, -7%) |
Evaluation: Die Qualität eines Knowledge Graphen zu bewerten, ist nicht einfach – vor allem, wenn Ground-Truth-Daten fehlen. Qualitativ geht es, indem man einzelne Tripel auf ihren Wahrheitsgehalt prüft: Stimmt „Pablo Picasso – malte – Guernica“?
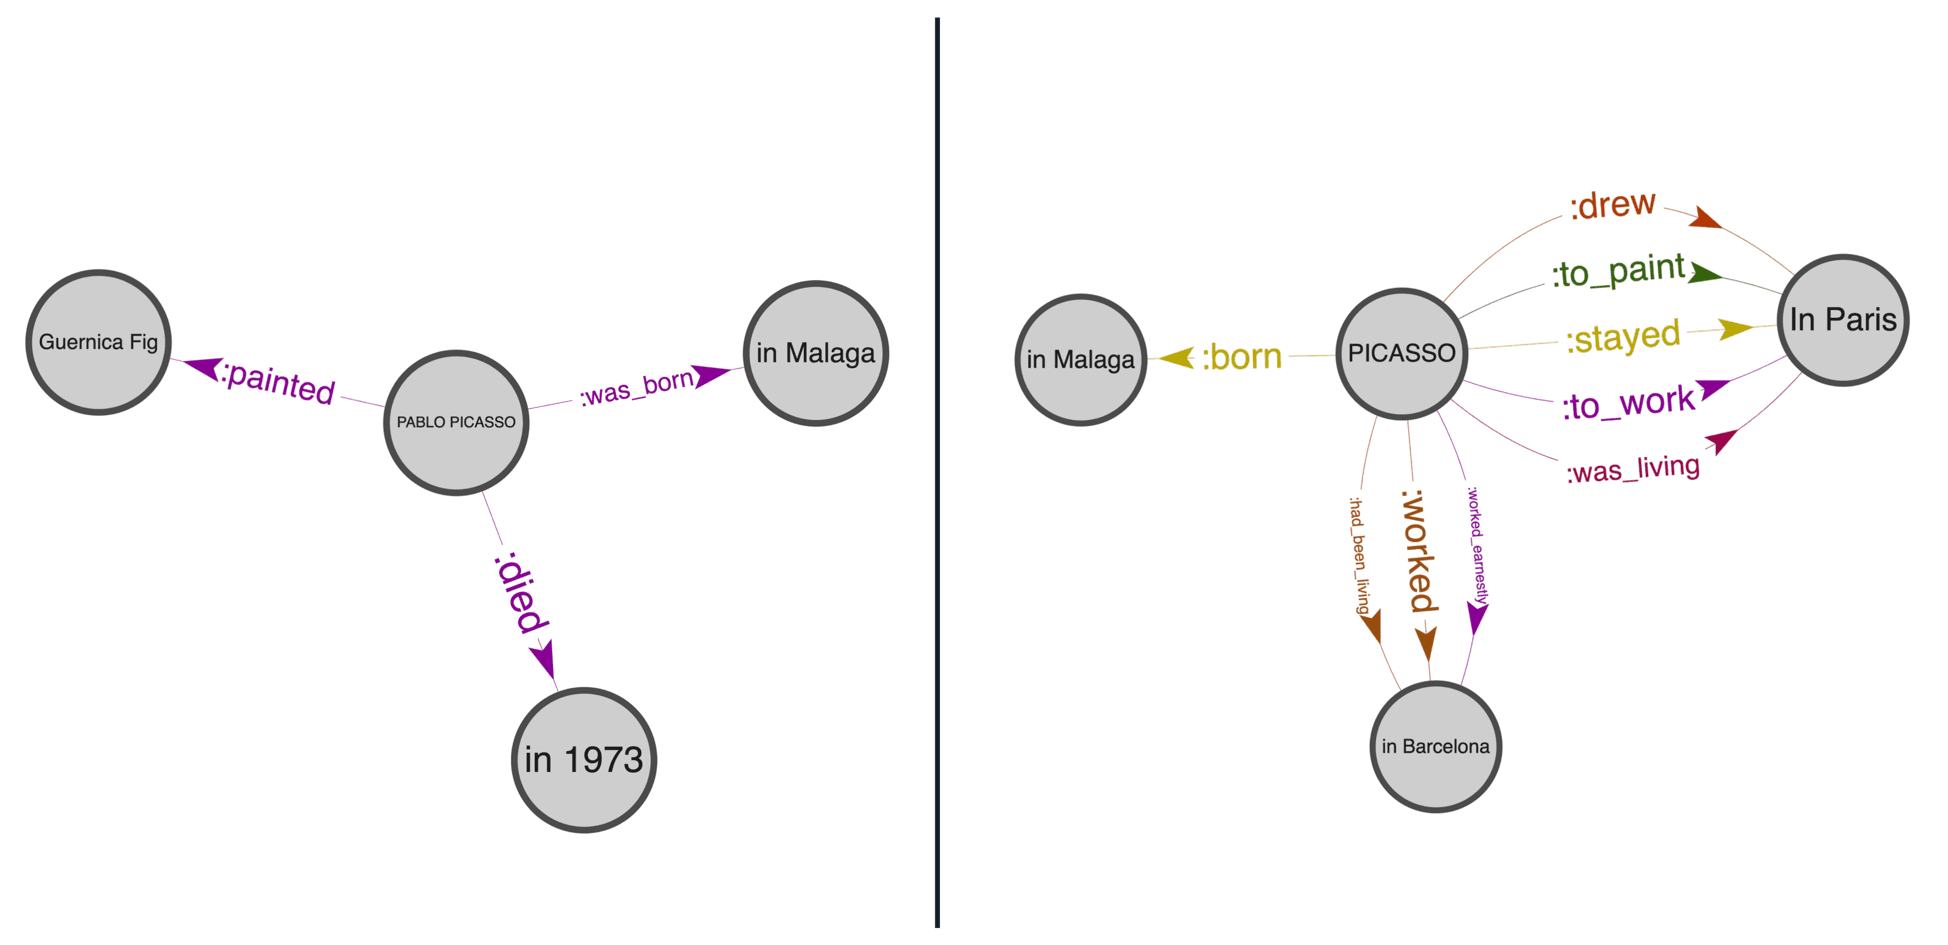
Die Cluster-Qualität haben wir manuell bewertet – Cluster für Cluster, mit ihren Entitäten und Relationen. Quantitativ ist das nicht, also haben wir uns eine eigene Ground Truth gebaut und damit eine Reihe von Abfragen gegen den Graphen laufen lassen. So konnten wir auch verschiedene Konfigurationen von Embeddings und Canonicalization gegeneinander vergleichen.
Eine Abfrage prüft etwa, ob „Picasso – malte – Guernica“ oder eine ähnliche Form im Graphen steht. Hier sind 5 Beispiele aus unserem Evaluationspool:
- Picasso - painted - Guernica
- Picasso - was_born_in - Malaga
- Eva Gouel - died_of - tuberculosis
- Olga Picasso - has_son - Paulo Picasso
- Museu Picasso - in - Barcelona
Am besten lief CESI mit HolE als Embedding, trainiert mit rund 100 Dimensionen und mit vortrainierten GloVE-Embeddings für die Wortvektoren. In dieser Konfiguration waren 80 % unserer vordefinierten Abfragen korrekt im Knowledge Graph abgebildet.
Fazit: Das Projekt hat echt Spaß gemacht und war eine gute Gelegenheit, mit einem nicht-öffentlichen Datensatz zu arbeiten und tief in die Konstruktion von Knowledge Graphen einzusteigen. Ohne Ground-Truth-Daten bleibt die Bewertung schwierig – für einen Graphen aus historischen Dokumenten sind wir mit dem Ergebnis aber sehr zufrieden.
Footnotes
-
Hogan, A. et al. (2021). Knowledge Graphs. ACM Comput. Surv., 54(4). ↩
-
Noy, N., et al. (2019). Industry-Scale Knowledge Graphs: Lessons and Challenges. ↩
-
Fensel, A. (2020). How to Build a Knowledge Graph. In Knowledge Graphs: Methodology, Tools and Selected Use Cases (pp. 11–68). ↩
-
Kolluru, K. et al. (2020). OpenIE6: Iterative Grid Labeling and Coordination Analysis for Open Information Extraction. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 3748–3761). ACL. ↩